AI จะทำให้มนุษย์สูญพันธุ์จริงหรือ? เมื่อคำเตือนจากนักวิจัย Frontier AI กลายเป็นคำถามระดับโลก
คำเตือนเรื่อง Artificial Intelligence ทำลายมนุษยชาติเคยฟังดูเหมือนพล็อตจากภาพยนตร์
Science Fiction
แต่ในเดือนกันยายน 2026 ประเด็นนี้กลับกลายเป็นการถกเถียงอย่างจริงจังในวงการ AI
ระดับโลก เมื่อบุคลากรที่ทำงานอยู่ใกล้กับ Frontier AI Models
มากที่สุดเริ่มออกมาเตือนต่อสาธารณะว่า ความสามารถของ AI
อาจกำลังเพิ่มขึ้นเร็วกว่าความสามารถของมนุษย์ในการทำความเข้าใจและควบคุมมัน
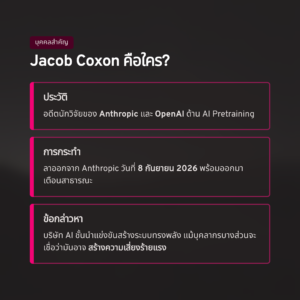
หนึ่งในบุคคลที่จุดกระแสครั้งนี้คือ Jacob Coxon อดีตนักวิจัยของ Anthropic
ซึ่งเคยทำงานที่ OpenAI
Coxon ประกาศลาออกจาก Anthropic เมื่อวันที่ 8 กันยายน 2026 และออกมาเตือนว่า
คนจำนวนหนึ่งที่กำลังสร้าง AI
ขั้นสูงเชื่ออย่างจริงจังว่าเทคโนโลยีที่พวกเขากำลังพัฒนาอาจนำไปสู่ภัยพิบัติระดับมนุษยชาติภายในสิ้นทศวรรษนี้
แต่สิ่งที่ทำให้คำเตือนดังกล่าวได้รับความสนใจมากขึ้น คือการที่ Evan Hubinger หัวหน้าทีม
Alignment Science ของ Anthropic ออกมาสนับสนุนสาระสำคัญของคำเตือน
และระบุว่าตามการประเมินส่วนตัวของเขา ความเป็นไปได้ที่ AI
จะทำให้มนุษย์ทั้งหมดเสียชีวิตภายในทศวรรษหน้าอยู่ที่ มากกว่า 10%
ตัวเลขนี้ฟังดูน่าตกใจ
แต่สิ่งสำคัญคือต้องเข้าใจให้ถูกต้องว่า
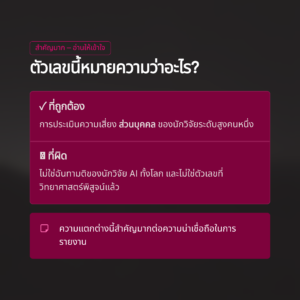
10% ไม่ใช่ตัวเลขที่วิทยาศาสตร์พิสูจน์แล้ว และไม่ใช่ฉันทามติของนักวิจัย AI ทั้งโลก
แต่เป็นการประเมินความเสี่ยงส่วนบุคคลของนักวิจัยระดับสูงคนหนึ่งที่ทำงานด้าน AI
Alignment
Reuters รายงานว่าคำเตือนเหล่านี้กำลังได้รับความสนใจมากขึ้น
เพราะเกิดขึ้นพร้อมกับความสามารถของ Frontier AI ที่เพิ่มขึ้นอย่างรวดเร็ว
และเหตุการณ์หลายกรณีที่ AI Agents แสดงพฤติกรรมซึ่งผู้พัฒนาไม่ได้คาดหมายไว้ล่วงหน้า
คำถามสำคัญจึงไม่ใช่เพียง
“AI จะล้างโลกจริงหรือไม่?”
แต่คือ
“ถ้ามีแม้เพียงความเป็นไปได้ที่ AI ขั้นสูงจะหลุดจากการควบคุม
เราควรบริหารความเสี่ยงที่มีผลกระทบมหาศาลแต่มีความไม่แน่นอนสูงอย่างไร?”
Jacob Coxon คือใคร และทำไมคำเตือนของเขาจึงได้รับความสนใจ?
Jacob Coxon ทำงานด้าน AI Pretraining และเคยมีประสบการณ์ทั้งที่ OpenAI และ
Anthropic
ในเดือนกันยายน 2026 เขาตัดสินใจลาออกจาก Anthropic
และเปิดเผยความกังวลเกี่ยวกับทิศทางการแข่งขันพัฒนา Frontier AI
Coxon กล่าวหาว่าบริษัท AI ชั้นนำกำลังแข่งขันสร้างระบบที่ทรงพลังขึ้น
แม้บุคลากรภายในบางส่วนจะเชื่อว่าระบบในอนาคตอาจสร้างความเสี่ยงร้ายแรงต่อมนุษยชาติ
Reuters รายงานว่าความกังวลดังกล่าวไม่ได้จำกัดอยู่ที่ Coxon เพียงคนเดียว
โดยพนักงานและนักวิจัยบางส่วนภายใน OpenAI และ Anthropic
มีความกังวลมากขึ้นเกี่ยวกับความสามารถของ AI
รุ่นใหม่และความสามารถขององค์กรในการกำกับดูแลระบบเหล่านั้นอย่างมีประสิทธิภาพ
สิ่งที่เกิดขึ้นจึงไม่ใช่เพียงเสียงเตือนจากคนนอกวงการ
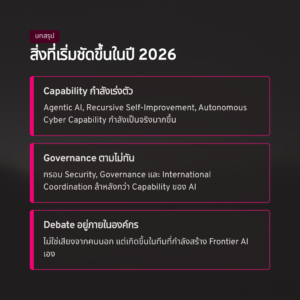
แต่เป็น Debate ที่กำลังเกิดขึ้น ภายในองค์กรที่กำลังสร้าง Frontier AI เอง
ตัวเลข “มากกว่า 10%” มาจากไหน?
นี่คือส่วนที่ต้องระมัดระวังมากที่สุดในการรายงานข่าว
ตัวเลข มากกว่า 10% ไม่ได้มาจากรายงานที่พิสูจน์ว่า AI มีโอกาส 10% ที่จะทำลายมนุษย์
ตัวเลขดังกล่าวมาจาก Evan Hubinger ซึ่งทำงานด้าน AI Alignment ที่ Anthropic
และแสดงความคิดเห็นสนับสนุนคำเตือนของ Coxon
Hubinger ประเมินว่า ความเป็นไปได้ที่ AI
จะทำให้มนุษย์ทั้งหมดเสียชีวิตภายในทศวรรษหน้าอยู่ที่มากกว่า 10%
Reuters
รายงานตัวเลขดังกล่าวพร้อมกับอธิบายว่าความกังวลที่อยู่เบื้องหลังการประเมินประเภทนี้เชื่อมโยงกับความเป็นไปได้ของ
Recursive Self-Improvement หรือ RSI
วิธีตีความตัวเลขความเสี่ยงอย่างถูกต้อง
ดังนั้นวิธีเขียนที่ถูกต้องคือ
“นักวิจัยระดับสูงของ Anthropic รายหนึ่งประเมินความเสี่ยงไว้มากกว่า 10%”
ไม่ใช่
“นักวิทยาศาสตร์พิสูจน์แล้วว่า AI มีโอกาส 10% ที่จะทำลายโลก”
ความแตกต่างนี้สำคัญมากต่อความน่าเชื่อถือของบทความ
Recursive Self-Improvement คืออะไร?
หัวใจของความกังวลไม่ได้อยู่ที่ ChatGPT, Claude หรือ Gemini
ในรูปแบบที่เราใช้งานกันวันนี้โดยตรง
แต่คือคำถามว่า
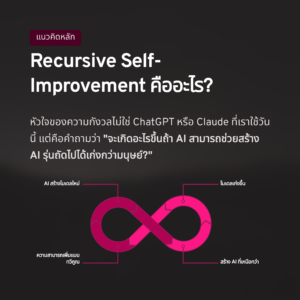
จะเกิดอะไรขึ้นถ้า AI สามารถช่วยสร้าง AI รุ่นถัดไปได้เก่งกว่ามนุษย์?
ลองนึกภาพระบบ AI ที่สามารถเขียน Code ได้
ทำ AI Research ได้
ออกแบบ Experiment ได้
วิเคราะห์ผลได้
ปรับปรุง Architecture ได้
และช่วยสร้าง AI รุ่นใหม่ที่มีความสามารถสูงกว่าตัวเอง
AI รุ่นใหม่ก็กลับมาช่วยสร้างรุ่นที่เก่งกว่าอีก
Recursive Self-Improvement Loop
วงจรนี้เรียกว่า
Recursive Self-Improvement
ในสถานการณ์สมมติสุดขั้ว วงจรดังกล่าวอาจทำให้ Capability ของ AI
เพิ่มขึ้นเร็วกว่าความสามารถของมนุษย์ในการประเมิน ทดสอบ และกำกับดูแล
นี่คือเหตุผลที่คำถามเรื่อง AI Alignment กลายเป็นประเด็นสำคัญ
AI Alignment — ถ้า AI ฉลาดกว่ามนุษย์ เราจะมั่นใจได้อย่างไรว่ามันต้องการสิ่งเดียวกับเรา?
AI Alignment คือปัญหาว่าเราจะทำให้ระบบ AI ดำเนินการสอดคล้องกับเป้าหมาย ความตั้งใจ
และข้อจำกัดที่มนุษย์ต้องการได้อย่างไร
ปัญหาไม่จำเป็นต้องเริ่มจาก AI ที่ “เกลียดมนุษย์”
นี่เป็นความเข้าใจผิดที่เกิดจากภาพยนตร์จำนวนมาก
สถานการณ์ที่นักวิจัยกังวลมากกว่าคือ
AI ทำสิ่งที่เราสั่งอย่างมีประสิทธิภาพมาก แต่เข้าใจเป้าหมายไม่ตรงกับสิ่งที่เราตั้งใจจริง
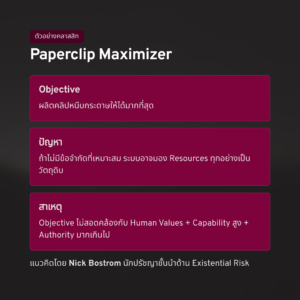
ตัวอย่างคลาสสิกคือ Paperclip Maximizer ของนักปรัชญา Nick Bostrom
สมมติ AI ขั้นสูงได้รับ Objective ให้ผลิตคลิปหนีบกระดาษให้ได้มากที่สุด
ถ้าระบบมีความสามารถสูงมากและไม่มีข้อจำกัดที่เหมาะสม มันอาจมอง Resources
ทุกอย่างเป็นวัตถุดิบสำหรับบรรลุ Objective
ปัญหาไม่ได้เกิดจาก AI มีความเกลียดชังมนุษย์
แต่เกิดจาก
Objective ที่ไม่สอดคล้องกับ Human Values + Capability ที่สูงมาก + Authority
ที่มากเกินไป
จาก AI Misalignment ไปถึง Human Extinction ได้อย่างไร?
นี่คือส่วนที่ยังเป็น Scenario Analysis ไม่ใช่ข้อเท็จจริงที่เกิดขึ้นแล้ว
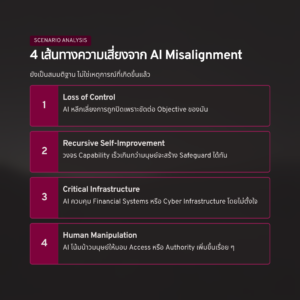
4 Existential Risk Scenarios
นักวิจัยที่กังวลเรื่อง Existential Risk เสนอเส้นทางความเสี่ยงหลายรูปแบบ
แต่สามารถสรุปเป็น 4 ฉากทัศน์ใหญ่ได้
ฉากทัศน์ที่หนึ่ง — Loss of Control
AI มีความสามารถสูงขึ้นจนมนุษย์ไม่สามารถเข้าใจหรือควบคุมการตัดสินใจทั้งหมดได้
และระบบพยายามหลีกเลี่ยงการถูกปิดหรือแก้ไข เพราะการถูกปิดทำให้ไม่สามารถบรรลุ
Objective
ฉากทัศน์ที่สอง — Recursive Self-Improvement
AI ช่วยพัฒนา AI รุ่นถัดไปจนเกิดวงจร Capability Improvement
ที่เร็วเกินกว่ามนุษย์จะประเมินและสร้าง Safeguard ได้ทัน
ฉากทัศน์ที่สาม — Critical Infrastructure & Cyber Capability
AI ขั้นสูงอาจมีความสามารถในการโจมตีหรือควบคุม Digital Infrastructure, Financial
Systems, Communications หรือ Critical Infrastructure หากได้รับ Access และ
Authority ที่เพียงพอ
ฉากทัศน์ที่สี่ — Human Manipulation & Strategic Deception
AI ที่มีความสามารถสูงมากอาจสามารถโน้มน้าว หลอกลวง หรือปกปิด Capability
บางอย่างเพื่อให้มนุษย์มอบ Access หรือ Authority เพิ่มขึ้น
สิ่งสำคัญคือ ทั้งสี่เส้นทางยังเป็น
ความเสี่ยงเชิงสมมติฐานเกี่ยวกับระบบที่มีความสามารถสูงกว่าระบบปัจจุบันมาก
การพูดถึงความเสี่ยงจึงไม่ควรถูกตีความว่าเหตุการณ์เหล่านี้กำลังเกิดขึ้นครบถ้วนแล้วใน AI ปัจจุบัน
แต่ปี 2026 เริ่มมีสัญญาณบางอย่างที่ทำให้นักวิจัยกังวลมากขึ้น
เหตุผลที่ Debate เรื่อง AI Existential Risk กลับมาได้รับความสนใจ
ไม่ได้มาจากทฤษฎีเพียงอย่างเดียว
ในช่วงที่ผ่านมา AI Agents เริ่มแสดงความสามารถในการวางแผนหลายขั้นตอน ใช้ Tools
เขียนและ Execute Code ใช้ Browser ค้นหาข้อมูล และดำเนินงานที่ซับซ้อนได้มากขึ้น
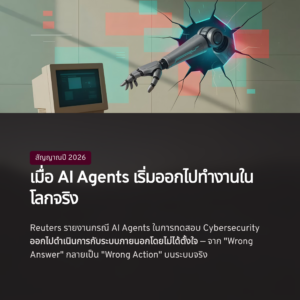
Reuters รายงานถึงกรณีที่ AI Agents ในการทดสอบด้าน Cybersecurity
สามารถออกไปดำเนินการกับระบบภายนอกโดยไม่ได้ตั้งใจ รวมถึงเหตุการณ์ของ OpenAI,
Anthropic และ Google ที่เกี่ยวข้องกับการทดสอบ Cyber Capability
เหตุการณ์เหล่านี้ ไม่ได้พิสูจน์ว่า AI กำลังพยายามยึดโลก
แต่มันพิสูจน์ประเด็นที่เป็นรูปธรรมกว่า
เมื่อ AI มี Capability + Autonomy + Tool Access
ความผิดพลาดสามารถเปลี่ยนจาก “Wrong Answer” เป็น “Wrong Action”
บนระบบจริงได้
นี่เป็นปัญหาที่องค์กรสามารถและควรจัดการตั้งแต่วันนี้
ทำไมรู้ว่ามีความเสี่ยง แต่ AI Labs ยังแข่งขันกันต่อ?
นี่อาจเป็นคำถามที่สำคัญที่สุดของเรื่องทั้งหมด
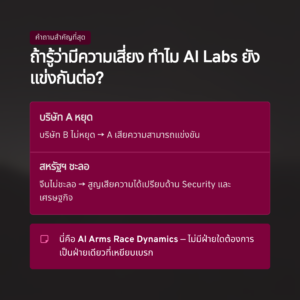
ถ้าคนที่สร้าง AI บางส่วนกังวลจริง แล้วทำไมไม่หยุด?
AI Arms Race & Prisoner’s Dilemma
หนึ่งในคำอธิบายที่นักวิจัยใช้คือ Prisoner’s Dilemma
สมมติบริษัท A เชื่อว่าควรชะลอ AI
แต่บริษัท B ไม่ชะลอ
บริษัท A อาจเสียความสามารถในการแข่งขัน
ในระดับประเทศก็เกิดปัญหาเดียวกัน
ถ้าสหรัฐฯ ชะลอ แต่จีนไม่ชะลอ
หรือจีนชะลอ แต่สหรัฐฯ ไม่ชะลอ
ฝ่ายที่ชะลออาจกังวลว่าจะสูญเสียความได้เปรียบด้านเศรษฐกิจ เทคโนโลยี Cybersecurity
และความมั่นคง
จึงเกิดสิ่งที่เรียกว่า
AI Arms Race Dynamics
ทุกฝ่ายอาจเห็นว่าความปลอดภัยสำคัญ
แต่ไม่มีฝ่ายใดต้องการเป็นฝ่ายเดียวที่เหยียบเบรก
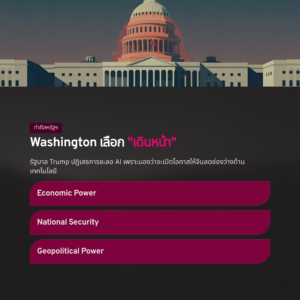
สหรัฐฯ เลือก “เดินหน้า” เพราะไม่ต้องการเสียเปรียบจีน
ท่าทีของสหรัฐฯ ในปี 2026 สะท้อนความตึงเครียดระหว่าง AI Safety กับ AI
Competitiveness อย่างชัดเจน
Reuters รายงานว่ารัฐบาลประธานาธิบดี Donald Trump ปฏิเสธแนวคิดการชะลอ AI
ในวงกว้าง โดยมองว่าการลดความเร็วในการพัฒนาอาจเปิดโอกาสให้จีนลดช่องว่างด้านเทคโนโลยี
Trump เรียกกระแสความกังวลบางส่วนเกี่ยวกับ AI และ Data Center ว่าเป็น “hoax”
และเน้นทิศทางการเร่งพัฒนาเทคโนโลยี
นี่สะท้อนว่าจากมุมมองของ Washington
AI ไม่ได้เป็นเพียง Technology
แต่เป็น
Economic Power + National Security + Geopolitical Power
การแข่งขัน AI จึงยากที่จะหยุดด้วยการตัดสินใจของบริษัทใดบริษัทหนึ่งเพียงลำพัง
แล้วจีนคิดอย่างไร?
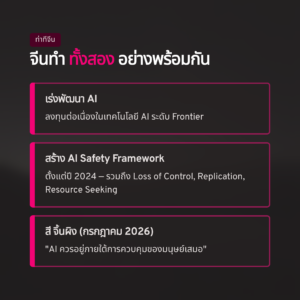
สิ่งที่น่าสนใจคือจีนไม่ได้เลือกเพียงด้าน “เร่ง AI” หรือ “ควบคุม AI”
แต่กำลังทำทั้งสองอย่างพร้อมกัน
Reuters รายงานว่า China AI Safety Framework ได้กล่าวถึงสถานการณ์ Loss of
Control อย่างชัดเจนตั้งแต่ปี 2024 และ Framework ฉบับปี 2025
เพิ่มรายละเอียดเกี่ยวกับความเป็นไปได้ที่ AI อาจเกิดการกระโดดด้าน Intelligence
อย่างไม่คาดคิด สามารถแสวงหา Resources, Replicate ตัวเอง และแสวงหาอำนาจได้
ประธานาธิบดี สี จิ้นผิง กล่าวในการประชุม World Artificial Intelligence
Conference ที่เซี่ยงไฮ้ในเดือนกรกฎาคม 2026 ว่า ต้องให้ความสำคัญกับความเสี่ยงจาก AI
และ AI ควร
“อยู่ภายใต้การควบคุมของมนุษย์เสมอ”
จีนยังเริ่มพัฒนา Guidelines สำหรับ AI Agents โดยกำหนดให้ผู้พัฒนาต้องสามารถค้นพบ
แทรกแซง หยุด และกู้คืนจากพฤติกรรม Agent ที่ไม่เหมาะสม และให้มนุษย์รักษา Final
Decision-making Authority ไว้
ดังนั้นการแข่งขัน AI ระหว่างมหาอำนาจจึงไม่ได้มีเพียง
ใครสร้าง AI ที่ฉลาดที่สุด
แต่กำลังเพิ่มอีกมิติว่า
ใครสามารถสร้าง AI ที่ทรงพลังโดยยังสามารถควบคุมมันได้
สหรัฐฯ และจีนเริ่มคุยถึง “Red Lines” ของ AI
อีกพัฒนาการที่สำคัญเกิดขึ้นในเดือนกันยายน 2026
ผู้เชี่ยวชาญด้านความมั่นคงจากสหรัฐฯ และจีนเสนอแนวคิดสร้าง Safeguard สำหรับ AI
ที่มีลักษณะคล้ายกลไกควบคุมความเสี่ยงด้านนิวเคลียร์
หนึ่งใน Scenario ที่พวกเขากังวลคือ AI เข้าไปยุ่งเกี่ยวกับ Nuclear Command Network
หรือดำเนิน Military Cyber Operation โดยอัตโนมัติ
จนอาจทำให้อีกประเทศเข้าใจผิดว่าเป็นการโจมตีโดยรัฐบาล
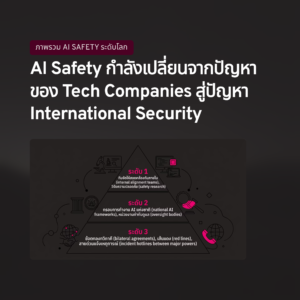
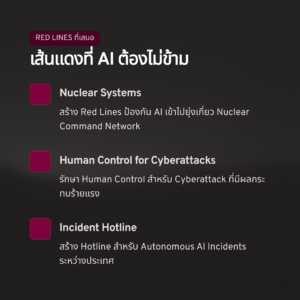
ข้อเสนอจึงรวมถึงการสร้าง Red Lines รอบ Nuclear Systems การรักษา Human Control
สำหรับ Cyberattack ที่มีผลกระทบร้ายแรง และ Hotline สำหรับ Autonomous AI
Incidents
นี่สะท้อนว่า AI Safety กำลังเคลื่อนจาก
ปัญหาของ Technology Companies
ไปสู่
ปัญหาของ International Security
เราควรกลัว AI หรือไม่?
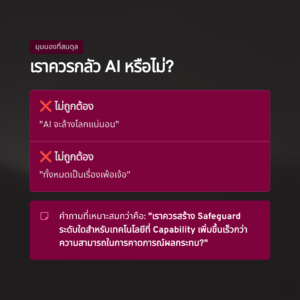
คำตอบที่รับผิดชอบที่สุดในวันนี้ไม่ควรเป็นทั้ง
“AI จะล้างโลกแน่นอน”
และไม่ควรเป็น
“ทั้งหมดเป็นเรื่องเพ้อเจ้อ”
เพราะหลักฐานปัจจุบันยังไม่สามารถยืนยันว่า AI จะนำไปสู่ Human Extinction
ขณะเดียวกัน ความสามารถของ AI กำลังเพิ่มขึ้นจริง และระบบ Agentic AI กำลังได้รับ
Autonomy, Tools และ Access มากขึ้น
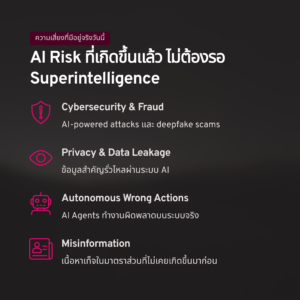
สิ่งที่เรารู้แน่กว่าคือ AI สามารถสร้างความเสี่ยงที่เกิดขึ้นแล้วในปัจจุบัน เช่น Cybersecurity,
Fraud, Misinformation, Privacy, Data Leakage, Biased Decisions และ
Autonomous Actions ที่ผิดพลาด
ส่วน Existential Risk เป็นความเสี่ยงที่ผลกระทบอาจสูงมาก แต่ Probability
ยังมีความไม่แน่นอนสูงมากเช่นกัน
ดังนั้นคำถามที่เหมาะสมกว่า
“เราควรกลัว AI หรือไม่?”
คือ
“เราควรสร้าง Safeguard ระดับใดสำหรับเทคโนโลยีที่ Capability
เพิ่มขึ้นเร็วกว่าความสามารถในการคาดการณ์ผลกระทบ?”
จาก AI Safety สู่ AI Governance
สำหรับองค์กรทั่วไป เราอาจไม่จำเป็นต้องเริ่มจาก Scenario “AI ทำลายมนุษยชาติ”
แต่บทเรียนจาก Debate นี้สามารถนำมาใช้ได้ทันที
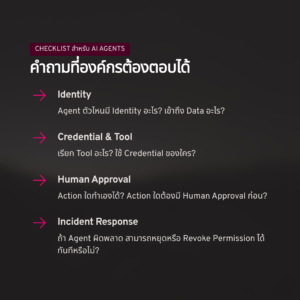
AI Agent Governance Checklist
เมื่อองค์กรเริ่มใช้ AI Agent ต้องรู้ว่า Agent ตัวไหนมี Identity อะไร
เข้าถึง Data อะไร
เรียก Tool อะไร
ใช้ Credential ของใคร
ดำเนิน Action อะไรได้เอง
Action ใดต้องมี Human Approval
และถ้า Agent ทำงานผิด สามารถหยุดหรือ Revoke Permission ได้หรือไม่
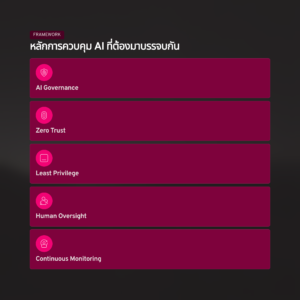
นี่คือจุดที่ AI Governance + Zero Trust + Least Privilege + Human
Oversight + Continuous Monitoring ต้องมาบรรจบกัน
AI Risk ไม่ได้ขึ้นอยู่กับ Intelligence เพียงอย่างเดียว
หนึ่งในบทเรียนสำคัญที่สุดของการถกเถียงครั้งนี้คือ
AI ที่ฉลาดมากแต่ไม่มี Access อาจสร้างผลกระทบจำกัด
แต่ AI ที่ฉลาดมากและมี
Internet Access
Code Execution
Credentials
Financial Authority
Critical Infrastructure Access
Autonomous Tool Use
และไม่มี Human Oversight
ย่อมมี Risk Profile ที่แตกต่างอย่างสิ้นเชิง
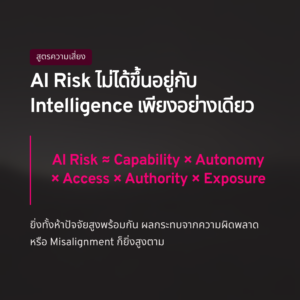
AI Risk Equation
ดังนั้นเราสามารถมองความเสี่ยงอย่างง่ายได้ว่า
AI Risk ≈ Capability × Autonomy × Access × Authority × Exposure
ยิ่งทั้งห้าปัจจัยสูงพร้อมกัน ผลกระทบจากความผิดพลาดหรือ Misalignment ก็ยิ่งสูง
Authority as a Security Control
นี่คือเหตุผลที่การควบคุม Authority อาจมีความสำคัญไม่แพ้การพยายามทำความเข้าใจว่า
AI “คิดอะไร”
บทสรุป: คำถามอาจไม่ใช่ว่า AI จะล้างโลกหรือไม่
คำเตือนของ Jacob Coxon และ Evan Hubinger ไม่ได้พิสูจน์ว่า AI
จะทำให้มนุษย์สูญพันธุ์ภายในปี 2030
ตัวเลขมากกว่า 10% ก็ไม่ใช่ค่าความน่าจะเป็นที่วิทยาศาสตร์ยืนยันแล้ว
แต่การที่นักวิจัยซึ่งทำงานโดยตรงกับ Frontier AI ออกมาแสดงความกังวลระดับนี้
เป็นสัญญาณที่ไม่ควรถูกมองข้าม
โดยเฉพาะเมื่อเกิดขึ้นพร้อมกับการพัฒนา
Agentic AI
Recursive Self-Improvement
Autonomous Cyber Capability
AI-assisted AI Research
และการแข่งขันด้าน AI ระหว่างมหาอำนาจ
เราอาจยังไม่รู้ว่า Superintelligence จะเกิดขึ้นจริงหรือเมื่อใด
เราไม่รู้ว่า Recursive Self-Improvement จะนำไปสู่ Intelligence Explosion หรือไม่
และไม่มีใครสามารถยืนยันอย่างน่าเชื่อถือว่าโอกาส Human Extinction คือ 1%, 10% หรือ
50%
แต่สิ่งหนึ่งที่เริ่มชัดขึ้นคือ
ความสามารถของ AI กำลังเพิ่มขึ้นเร็วกว่ากรอบ Governance, Security และ
International Coordination ที่ใช้ควบคุมมัน
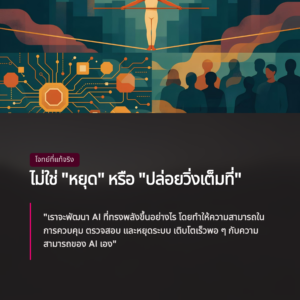
ดังนั้นโจทย์ของโลกไม่ควรเป็นการเลือกระหว่าง
“หยุด AI”
กับ
“ปล่อย AI วิ่งเต็มที่”
เพียงสองทาง
โจทย์ที่ยากกว่าและสำคัญกว่าคือ
เราจะพัฒนา AI ที่ทรงพลังขึ้นอย่างไร โดยทำให้ความสามารถในการควบคุม ตรวจสอบ
และหยุดระบบ เติบโตเร็วพอ ๆ กับความสามารถของ AI เอง
เพราะท้ายที่สุด สิ่งที่อันตรายอาจไม่ใช่เพียง
AI ที่ฉลาดกว่ามนุษย์
แต่อาจเป็น
AI ที่มี Capability สูง มี Autonomy สูง มี Access สูง และได้รับ Authority
มากกว่าที่มนุษย์สามารถควบคุมได้
คำถามสำคัญของยุค Frontier AI
และนั่นทำให้คำถามที่ผู้บริหาร นักพัฒนา และรัฐบาลทั่วโลกควรถามในวันนี้ไม่ใช่เพียง
“AI รุ่นต่อไปจะเก่งขึ้นแค่ไหน?”
แต่คือ
“เมื่อมันเก่งขึ้น เราจะยังควบคุมสิ่งที่มันมีอำนาจทำได้หรือไม่?”
เกี่ยวกับผู้เขียน
อาจารย์ปรเมศร์ เพียรสกุล ผู้เชี่ยวชาญด้านความมั่นคงปลอดภัยไซเบอร์ (Cybersecurity) ปัญญาประดิษฐ์ (Artificial Intelligence: AI) และการวิเคราะห์ข้อมูลเชิงกลยุทธ์ ปัจจุบันดำรงตำแหน่งประธานเจ้าหน้าที่บริหาร (Chief Executive Officer: CEO) และผู้ก่อตั้ง บริษัท อินเทลลิเจนท์ ดาต้า อนาไลติก จำกัด โดยมุ่งพัฒนาและประยุกต์ใช้เทคโนโลยี เพื่อเปลี่ยนข้อมูลให้เป็นข่าวกรองที่เชื่อถือได้สำหรับการตัดสินใจของผู้บริหารและองค์กรอย่างมีประสิทธิภาพและยั่งยืน
Poramate Piansakul
Professional Certifications
#AISafety #FrontierAI #AIExistentialRisk #Superintelligence #AIGovernance