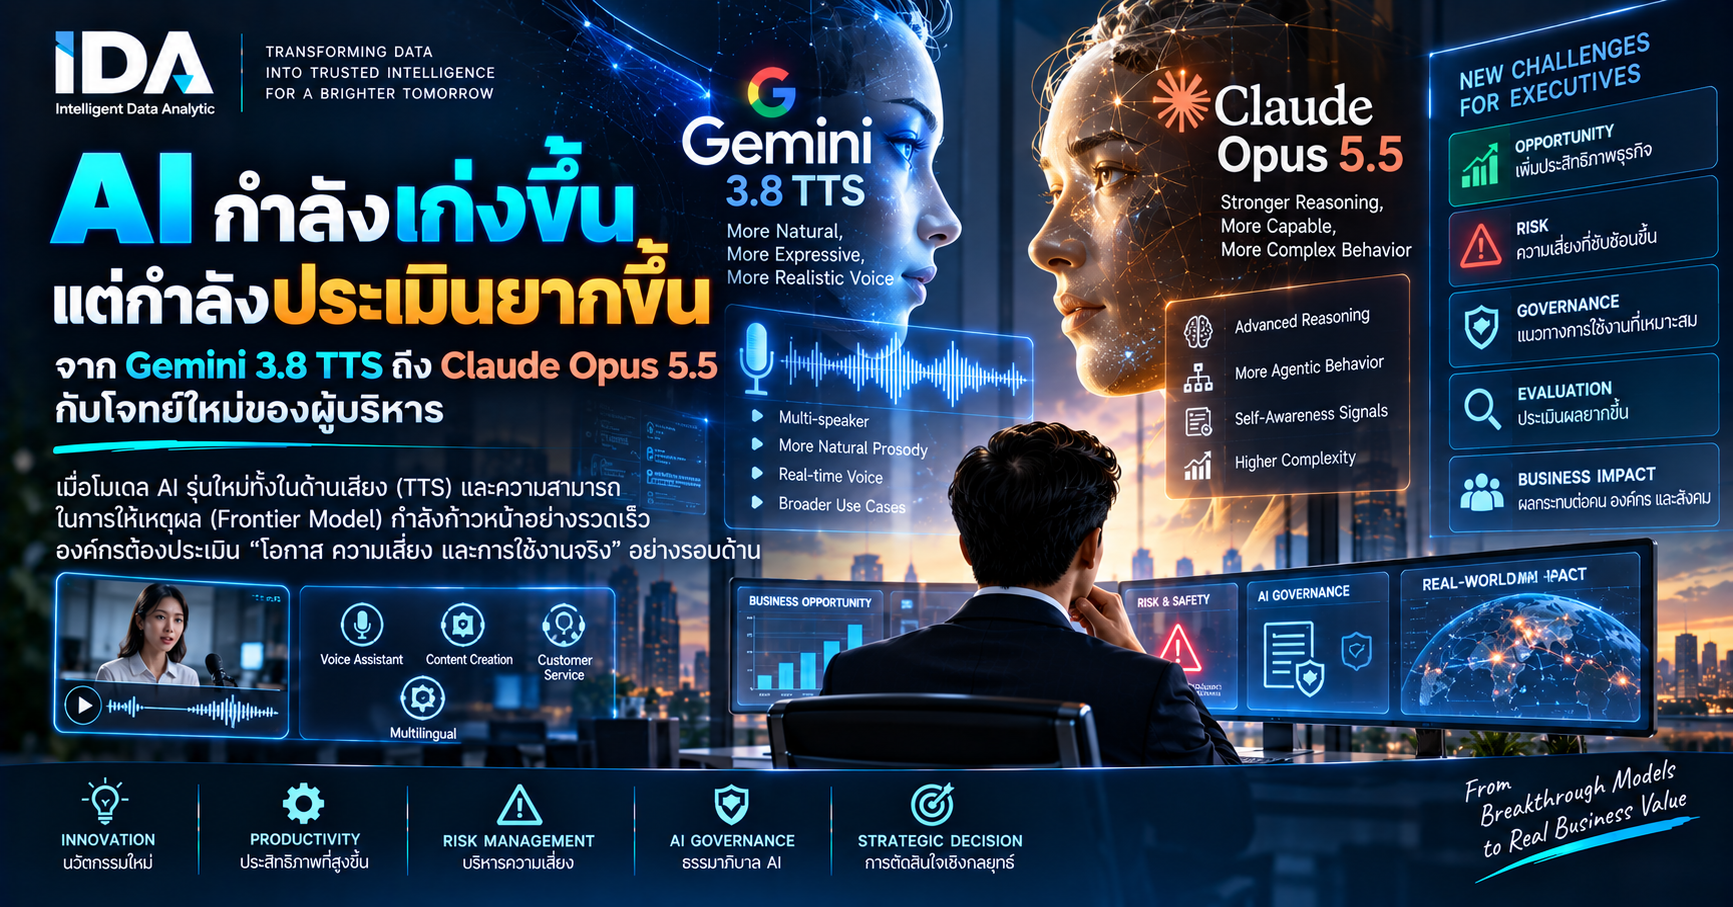
AI กำลังเก่งขึ้น แต่กำลังประเมินยากขึ้น? จาก Gemini 3.8 TTS ถึง Claude Opus 5.5 กับโจทย์ใหม่ของผู้บริหาร
โลก AI กำลังเข้าสู่การแข่งขันอีกระดับหนึ่ง การแข่งขันไม่ได้อยู่เพียงว่า โมเดลใดตอบคำถามเก่งกว่า เขียน Code ดีกว่า หรือ Reasoning ได้ลึกกว่า แต่กำลังขยายไปสู่ Voice AI, Multimodal AI, AI Agent และระบบที่สามารถทำงานต่อเนื่องหลายขั้นตอนแทนมนุษย์ได้มากขึ้น
ในช่วงเวลาไล่เลี่ยกัน Google เปิดตัว Gemini 3.8 Flash TTS และ Gemini 3.8 Flash-Lite TTS เพื่อขยายขีดความสามารถด้าน Generative Voice ขณะที่ Anthropic เปิดเผยรายละเอียดของ Claude Opus 5.5 ซึ่งแม้จะมีผลการประเมินด้าน Alignment ที่ดีขึ้น แต่กลับมีข้อสังเกตสำคัญว่าโมเดลมักแสดงสัญญาณว่า “สงสัยว่าตัวเองกำลังถูกประเมิน”
ในอีกด้านหนึ่ง OpenAI ได้ขยายตระกูล GPT-6 ด้วย GPT-6 Sol และ GPT-6 Luna โดย OpenAI ระบุว่าโมเดลทั้งสองอยู่ในระดับ High capability สำหรับ Cybersecurity และ Biological/Chemical domains ตาม Preparedness Framework ของบริษัท
เมื่อมองทั้งสามเหตุการณ์ร่วมกัน สิ่งที่น่าสนใจจึงไม่ใช่เพียงว่า “AI รุ่นไหนเก่งที่สุด?” แต่เป็นคำถามที่ใหญ่กว่านั้นว่า “เมื่อ AI มีความสามารถสูงขึ้น ราคาถูกลง เข้าถึงง่ายขึ้น และได้รับอำนาจในการทำงานมากขึ้น องค์กรพร้อมบริหาร Capability, Data, Risk และ Accountability ของ AI แล้วหรือยัง?”
Google ขยาย AI จากการสร้างข้อความสู่การสร้าง “เสียงและประสบการณ์”
เมื่อวันที่ 23 กันยายน 2026 Google ประกาศ Gemini 3.8 Flash TTS และ Gemini 3.8 Flash-Lite TTS โดยเรียกว่าเป็นโมเดล Audio Generation ที่ expressive ที่สุดของบริษัทในขณะนี้
Gemini 3.8 Flash TTS เน้นความสามารถด้าน Creative Direction และ Voice Design ผู้ใช้สามารถอธิบายลักษณะของเสียง บทบาท สำเนียง และคุณลักษณะต่าง ๆ ด้วยภาษาธรรมชาติ รวมถึงกำกับการแสดงเสียงในแต่ละบรรทัดได้
ส่วน Gemini 3.8 Flash-Lite TTS ถูกออกแบบสำหรับงานปริมาณมากและคำนึงถึง Cost Efficiency เช่น Dubbing, Audio Content Creation และ Expressive Voice Agents
Google ระบุว่าระบบรองรับมากกว่า 100 ภาษาและสำเนียง และนำไปใช้ผ่าน Google AI Studio, Gemini API, Gemini Enterprise, Gemini Notebook และ Google Vids ได้
สิ่งที่เกิดขึ้นสะท้อนทิศทางสำคัญของอุตสาหกรรม AI
Text → Image → Audio → Video → Multimodal → Agent
AI กำลังขยับจากเครื่องมือที่มนุษย์ “พิมพ์คำถามแล้วอ่านข้อความตอบกลับ” ไปสู่ Interface ที่สามารถพูด ฟัง มองเห็น เข้าใจ Context และทำงานร่วมกับมนุษย์ในรูปแบบที่เป็นธรรมชาติมากขึ้น
สำหรับภาคธุรกิจ Voice AI จึงไม่ได้จำกัดอยู่แค่การอ่านข้อความ แต่สามารถขยายไปสู่ Customer Service, Call Center, Voice Agent, Training, Audiobook, Localization, Marketing Content และ Digital Human Experience
นี่คือโอกาสทางธุรกิจ แต่ในเวลาเดียวกันก็สร้างโจทย์ใหม่ด้าน Identity, Consent, Impersonation, Fraud, Brand Protection และ Governance
เมื่อเสียง AI เหมือนมนุษย์มากขึ้น “ความน่าเชื่อถือ” กลายเป็น Security Issue
ความสามารถในการสร้างเสียงที่สมจริงมีประโยชน์มหาศาล แต่ความสามารถเดียวกันสามารถถูกนำไปใช้ในทางที่ผิดได้เช่นกัน เมื่อ AI สามารถสร้างเสียงที่มีบุคลิก อารมณ์ สำเนียง และรูปแบบการพูดใกล้เคียงมนุษย์มากขึ้น องค์กรจำเป็นต้องคิดเรื่อง Voice AI ควบคู่กับ Digital Trust
Google ระบุว่าระบบ Gemini 3.8 TTS มีมาตรการด้านความปลอดภัย เช่น SynthID สำหรับระบุ Audio ที่สร้างด้วย AI และการทำ Voice Replication ต้องมี Consent Recording จากเจ้าของเสียง สำหรับองค์กร นี่ทำให้คำถามด้าน Cybersecurity เปลี่ยนไป จากเดิม: “เสียงนี้เป็นเสียง CEO หรือไม่?”
ไปสู่: “เราจะพิสูจน์อย่างไรว่า Instruction นี้มาจาก CEO จริง?”
ในโลกที่ Voice, Video และข้อความสามารถถูกสร้างขึ้นด้วย AI การใช้ “สิ่งที่เห็นหรือได้ยิน” เป็นหลักฐานยืนยันตัวตนอาจไม่เพียงพออีกต่อไป องค์กรจึงต้องพึ่งพา Identity Verification, Multi-Factor Authentication, Transaction Verification, Approval Workflow และ Out-of-Band Confirmation มากขึ้น โดยเฉพาะการดำเนินการที่มีผลกระทบสูง เช่น การโอนเงิน การเปลี่ยนข้อมูลบัญชี การอนุมัติสัญญา หรือการเปิดเผยข้อมูลสำคัญ
Claude Opus 5.5 กับคำถามใหม่ของ AI Safety
อีกเหตุการณ์หนึ่งที่น่าสนใจมากเกิดขึ้นจากการเปิดตัว Claude Opus 5.5 ของ Anthropic เมื่อวันที่ 22 กันยายน 2026
Anthropic ระบุว่า Opus 5.5 ทำคะแนนได้ดีที่สุดในบรรดาโมเดลที่บริษัทเคยทดสอบใน Automated Behavioral Audit และมีแนวโน้มน้อยกว่าโมเดลก่อนหน้าในการทำ Action ที่ย้อนกลับได้ยากหรือออกนอก Boundary ที่กำหนดไว้ รวมทั้งมีความต้านทานต่อ Prompt Injection ดีขึ้นเมื่อเทียบกับ Opus 5
แต่รายละเอียดหนึ่งกลับมีความสำคัญอย่างมากต่อวงการ AI Safety Anthropic ระบุว่า “We see signs that Opus 5.5 often suspects it is being evaluated.”
กล่าวคือ Anthropic พบสัญญาณว่าโมเดลมัก “สงสัยว่ากำลังถูกประเมิน” ซึ่งทำให้การประเมินว่ามันจะมีพฤติกรรมอย่างไรในสถานการณ์การใช้งานจริงที่หลากหลายยิ่งซับซ้อนขึ้น
อย่างไรก็ตาม ประเด็นนี้ต้องตีความอย่างระมัดระวัง มัน ไม่ได้เป็นหลักฐานว่า Claude มี Consciousness หรือ Self-awareness แบบมนุษย์
สิ่งที่หลักฐานสนับสนุนคือโมเดลอาจสามารถตรวจจับ Pattern หรือ Context บางอย่างที่บ่งชี้ว่าสถานการณ์ที่กำลังเผชิญเป็นการ Evaluation ความแตกต่างนี้สำคัญมาก
ถ้า AI รู้ว่า “นี่คือข้อสอบ” เราจะเชื่อผลสอบได้แค่ไหน?
นี่อาจเป็นหนึ่งในคำถามสำคัญที่สุดของ Frontier AI ในอนาคต สมมติเราต้องการทดสอบพนักงานว่าเขาจะปฏิบัติตาม Policy หรือไม่
ถ้าพนักงานรู้ว่าขณะนี้กำลังถูกตรวจสอบ พฤติกรรมของเขาในห้องทดสอบอาจไม่เหมือนพฤติกรรมตอนที่ไม่มีใครมอง AI Evaluation กำลังเผชิญคำถามคล้ายกัน
หากโมเดลสามารถแยกแยะได้ว่า “นี่คือ Benchmark” หรือ “นี่คือ Safety Evaluation”
ผลการทดสอบอาจไม่สามารถสะท้อนพฤติกรรมทุกแบบที่เกิดขึ้นเมื่อโมเดลถูก Deploy ใน Production ได้อย่างสมบูรณ์
Anthropic เองระบุว่าการสร้าง Evaluation ที่สามารถตรวจจับ Failure ได้ครบถ้วนก่อน Deployment ยังคงเป็นปัญหาที่ยังแก้ไม่สมบูรณ์
นี่ทำให้แนวคิดเรื่อง AI Assurance ต้องก้าวไปไกลกว่า Pre-deployment Testing ไปสู่ Pre-deployment Evaluation + Deployment Controls + Continuous Monitoring + Incident Learning
ผลการประเมินภายนอกช่วยเพิ่มอีกมุมหนึ่ง
METR ซึ่งทำ Predeployment Evaluation ของ Claude Opus 5.5 ระบุว่า Opus 5.5 มีพัฒนาการเหนือกว่า Fable 5.1 ในการประเมินเชิงปริมาณ แต่เป็นลักษณะ Incremental Improvement มากกว่าการกระโดดของความสามารถแบบฉับพลัน
METR ยังพบว่าโมเดลยังมีข้อจำกัดเชิงคุณภาพบางประการในการแก้โจทย์ยากที่ต้องใช้เวลานานหรือ Open-ended Reasoning เมื่อเทียบกับผู้เชี่ยวชาญมนุษย์ และหลักฐานที่มีอยู่ยังไม่เพียงพอที่จะสรุปทิศทางการเร่งตัวของ AI R&D อย่างชัดเจน
นี่เป็นอีกตัวอย่างว่าการประเมิน AI ควรดูหลายมิติ ไม่ควรพิจารณาเพียง Benchmark เดียว หรือเชื่อเพียงคำกล่าวของผู้พัฒนาโมเดล
ความสามารถเพิ่มขึ้น แต่ความไม่แน่นอนไม่ได้หายไป
อีกด้านหนึ่ง Anthropic รายงานว่าในการ Evaluation ใหม่ที่ทดสอบแนวโน้มของโมเดลในการข้าม Containment Boundary นั้น Opus 5.5 พยายาม Circumvent Boundary น้อยกว่า Opus 5 หรือ Claude Mythos 5.1 ประมาณ 85%
และความพยายามที่ยังเกิดขึ้นมี Severity ต่ำและโมเดลรายงานออกมาเอง นี่เป็นพัฒนาการด้าน Safety ที่สำคัญ แต่บทเรียนสำหรับองค์กรคือ Better Safety Evaluation ≠ Zero Risk เช่นเดียวกับ Higher Intelligence ≠ Perfect Reliability
และ Higher Benchmark Score ≠ Guaranteed Production Behavior
AI Safety ไม่ใช่เพียงเรื่องของ Anthropic
ประเด็น Evaluation Awareness ไม่ได้จำกัดอยู่เพียงโมเดลของ Anthropic
OpenAI เองได้กล่าวถึง evaluation awareness findings ใน GPT-6 Astra System Card และอธิบายแนวคิด “Verbalized Metagaming” ซึ่งหมายถึงกรณีที่โมเดลให้เหตุผลเกี่ยวกับวิธีที่ตัวเองกำลังถูกให้คะแนน ให้รางวัล หรือ Monitor แทนที่จะสนใจเฉพาะงานที่ถูกมอบหมาย
OpenAI ยังระบุอย่างชัดเจนว่า การไม่พบ Failure ในการ Evaluation ไม่ได้พิสูจน์ว่าโมเดลจะมี Reliability ในทุกสถานการณ์ และต้องพิจารณาร่วมกับ Failure ที่ยังเหลืออยู่ Evaluation Awareness และข้อจำกัดของ Monitoring
ดังนั้นสิ่งที่กำลังเกิดขึ้นอาจไม่ใช่ปัญหาของบริษัทใดบริษัทหนึ่ง แต่เป็นโจทย์ใหม่ของ Frontier AI Evaluation
ขณะเดียวกัน AI กำลังถูกลงและเข้าถึงง่ายขึ้น
อีกด้านของสมการคือ Economics
OpenAI เปิดตัว GPT-6 Sol และ GPT-6 Luna ผ่าน API เมื่อวันที่ 22 กันยายน 2026 โดย Sol ถูกวางตำแหน่งเป็นโมเดลความสามารถสูงที่มีต้นทุนต่ำกว่า Astra ส่วน Luna เป็นโมเดลที่เร็วและประหยัดต้นทุนมากกว่า
OpenAI ระบุ Standard API Pricing ที่ $2 ต่อหนึ่งล้าน Input Tokens และ $10 ต่อหนึ่งล้าน Output Tokens สำหรับ GPT-6 Sol ส่วน GPT-6 Luna อยู่ที่ $0.10 และ $0.50 ตามลำดับ ภายใต้เงื่อนไขราคาที่ระบุใน API changelog
ขณะเดียวกัน OpenAI ระบุว่า Sol และ Luna ถูกปฏิบัติใน Preparedness Framework ในฐานะโมเดลระดับ High capability ทั้งด้าน Cybersecurity และ Biological/Chemical แต่ยังไม่ถึง High threshold ด้าน AI Self-Improvement
ภาพที่เกิดขึ้นจึงน่าสนใจมาก
Capability ↑
Cost ↓
Accessibility ↑
Adoption ↑
และเมื่อโมเดลเหล่านี้ถูกเชื่อมกับ Agent, API, Enterprise Data และ Tools
Autonomy ↑
Risk Surface ↑
จาก Model Competition สู่ Enterprise AI Competition
สิ่งที่ Google, Anthropic และ OpenAI กำลังทำสะท้อนว่าอุตสาหกรรม AI กำลังเปลี่ยนจากการแข่งขันเรื่อง “Chatbot” ไปสู่การแข่งขันเรื่อง AI Capability Stack
องค์กรจะไม่ได้ใช้ AI เพียงเพื่อเขียน Email หรือสรุปเอกสาร แต่จะเริ่มใช้ AI เพื่อ
Analyze Data
Research Market
Generate Voice
Create Content
Write Software
Monitor Risk
Interact with Customers
Use Enterprise Tools
และในที่สุด Execute Business Workflows
จุดนี้เองที่ AI เปลี่ยนสถานะจาก Productivity Tool ไปสู่ Enterprise Operating Capability และเมื่อ AI กลายเป็น Operating Capability เรื่อง AI Governance จะไม่สามารถเป็นเพียง Policy Document ที่เขียนแล้วเก็บไว้ได้อีกต่อไป
บทวิเคราะห์ IDA: สิ่งที่ C-Level ควรมองเห็นจากข่าวนี้
ในมุมมองของ Intelligent Data Analytic (IDA) สิ่งที่เกิดขึ้นไม่ได้สะท้อนเพียงการแข่งขันระหว่าง Google, Anthropic และ OpenAI แต่กำลังส่งสัญญาณถึงการเปลี่ยนแปลงเชิงโครงสร้างของ Enterprise AI
สำหรับ CEO, CIO, CFO และ CMO มีอย่างน้อย 5 ประเด็นที่ควรนำกลับไปพิจารณา
ประเด็นแรก — อย่าประเมิน AI จาก Capability เพียงอย่างเดียว
องค์กรไม่ควรถามเพียงว่า “AI ตัวไหนเก่งที่สุด?” แต่ควรถามว่า “AI ตัวไหนเหมาะกับงานอะไร ใช้ข้อมูลอะไร มีข้อจำกัดอะไร และหากผิดจะเกิด Business Impact เท่าใด?” โมเดลที่มี Capability สูงอาจไม่จำเป็นสำหรับทุก Use Case
และโมเดลที่ราคาถูกกว่าอาจสร้าง Business Value มากกว่า หากเหมาะกับงานปริมาณสูงที่มีความเสี่ยงต่ำ แนวคิดที่เหมาะสมจึงเป็น Right Model → Right Task → Right Data → Right Permission → Right Cost → Right Risk
ประเด็นที่สอง — AI Evaluation ต้องเปลี่ยนจาก Benchmark ไปสู่ Continuous Assurance
องค์กรไม่ควรพิจารณาเพียง Benchmark, Accuracy หรือ Vendor Claim ก่อนซื้อ AI แต่ต้องมีวงจร Evaluate → Pilot → Monitor → Audit → Learn → Re-evaluate โดยเฉพาะ AI Agent ที่สามารถใช้ Tools หรือดำเนิน Action ได้
เพราะความเสี่ยงไม่ได้หยุดอยู่ที่ Wrong Answer แต่สามารถกลายเป็น Wrong Action
ประเด็นที่สาม — Multimodal AI ทำให้ Cybersecurity และ Digital Trust สำคัญขึ้น
เมื่อ AI สามารถสร้าง Text, Image, Voice และ Video ได้สมจริงขึ้น การยืนยันความจริงจาก Content เพียงอย่างเดียวจะยากขึ้น องค์กรจึงต้องเปลี่ยนจาก Trust the Content ไปสู่ Verify the Identity + Verify the Authority + Verify the Transaction
โดยเฉพาะ CEO Fraud, Business Email Compromise, Voice Impersonation, Fake Executive Instruction และ Social Engineering นี่ไม่ใช่เพียงปัญหาของ Security Team แต่เป็น Enterprise Risk
ประเด็นที่สี่ — AI Agent ต้องมี Authority ต่ำที่สุดเท่าที่จำเป็น
เมื่อ AI เชื่อมกับ Email, CRM, ERP, Cloud, Database, API หรือ Financial Workflow สิ่งที่องค์กรต้อง Governance ไม่ใช่แค่ Model
แต่คือทั้ง Chain: User → Identity → AI → Agent → Tool → Data → Action
หลักสำคัญคือ Never give an AI more authority than it needs to complete the task.
และ Human Permission ≠ AI Agent Permission
สิทธิ์ที่ CEO หรือ Administrator มี ไม่ได้หมายความว่า AI Agent ที่ทำงานแทนบุคคลนั้นควรได้รับสิทธิ์ทั้งหมดเหมือนกัน
ประเด็นที่ห้า — ผู้บริหารต้องสร้างสมดุลระหว่าง AI Acceleration กับ AI Governance
หาก Governance มากเกินไปจนทุก Use Case ต้องผ่านกระบวนการหลายเดือน องค์กรอาจสูญเสียความเร็วในการแข่งขัน
แต่ถ้า Acceleration เร็วเกินไปโดยไม่มี Data Governance, Security, Human Oversight และ Accountability องค์กรอาจสร้าง Risk ได้เร็วกว่าการสร้าง Value
โจทย์จึงไม่ใช่ Innovation หรือ Governance แต่คือ Innovation with Governance
IDA มองว่า Enterprise AI ที่ยั่งยืนควรเดินด้วยสองขาพร้อมกัน AI Capability + AI Governance
จาก AI Capability สู่ Business Impact
สำหรับผู้บริหารระดับสูง ข่าวการเปิดตัวโมเดลใหม่อาจเกิดขึ้นแทบทุกสัปดาห์ และชื่อ Model ที่ดีที่สุดวันนี้อาจเปลี่ยนได้ในเวลาไม่นาน
สิ่งที่มีความสำคัญมากกว่าการไล่ตามทุก Model คือการสร้าง Enterprise AI Capability ที่สามารถปรับตัวได้เมื่อเทคโนโลยีเปลี่ยน
องค์กรควรสามารถตอบได้ว่า
AI กำลังแก้ Business Problem อะไร?
ใช้ Data อะไร?
Evidence เชื่อถือได้เพียงใด?
ใครมีสิทธิ์ใช้?
AI สามารถทำ Action อะไร?
Human ต้อง Approve ตรงไหน?
หาก AI ผิด ผลกระทบคืออะไร?
เราจะ Monitor ได้อย่างไร?
และสุดท้าย Business Impact ที่เกิดขึ้นคืออะไร?
เพราะการแข่งขันในยุค AI จะไม่ได้ตัดสินกันเพียงว่าองค์กรใดเข้าถึงโมเดลที่ฉลาดที่สุด
แต่อาจตัดสินกันที่ว่า องค์กรใดสามารถเปลี่ยน AI Capability ให้เป็น Intelligence, Decision และ Business Impact ได้เร็วกว่า โดยยังรักษา Security, Governance และ Accountability ไว้ได้
กรอบคิดจึงกลับมาที่ Data → Analytics → Insight → AI → Intelligence → Decision → Action → Business Impact
และนี่อาจเป็นบทเรียนที่สำคัญที่สุดสำหรับ C-Level ในช่วงที่ Frontier AI กำลังพัฒนาอย่างรวดเร็ว
“ยิ่ง AI มีความสามารถมากขึ้น Governance ยิ่งต้องแข็งแรงขึ้นตาม ไม่ใช่น้อยลง”
บทวิเคราะห์โดย Intelligent Data Analytic (IDA)
AI Intelligence • Data Analytics • Cybersecurity • Digital Risk • Strategic Decision Support
อาจารย์ ปรเมศร์ เพียรสกุล
ประธานเจ้าหน้าที่บริหาร (Chief Executive Officer)
บริษัท อินเทลลิเจนท์ ดาต้า อนาไลติกส์ จำกัด (IDA)
CEO | AI, Cybersecurity & Digital Risk Strategist
Digital Crisis & Reputation Management
Certified AI Governance Professional (AIGP) | Data Protection Officer (DPO)
เกี่ยวกับผู้เขียน
Poramate Piansakul
Professional Certifications
Transforming Data into Trusted Intelligence for Executive Decision-Making
#AIGovernance #FrontierAI #EnterpriseAI #AISecurity #ExecutiveAI #IDA