แล้วทำไม Jev ถึงเร็ว?
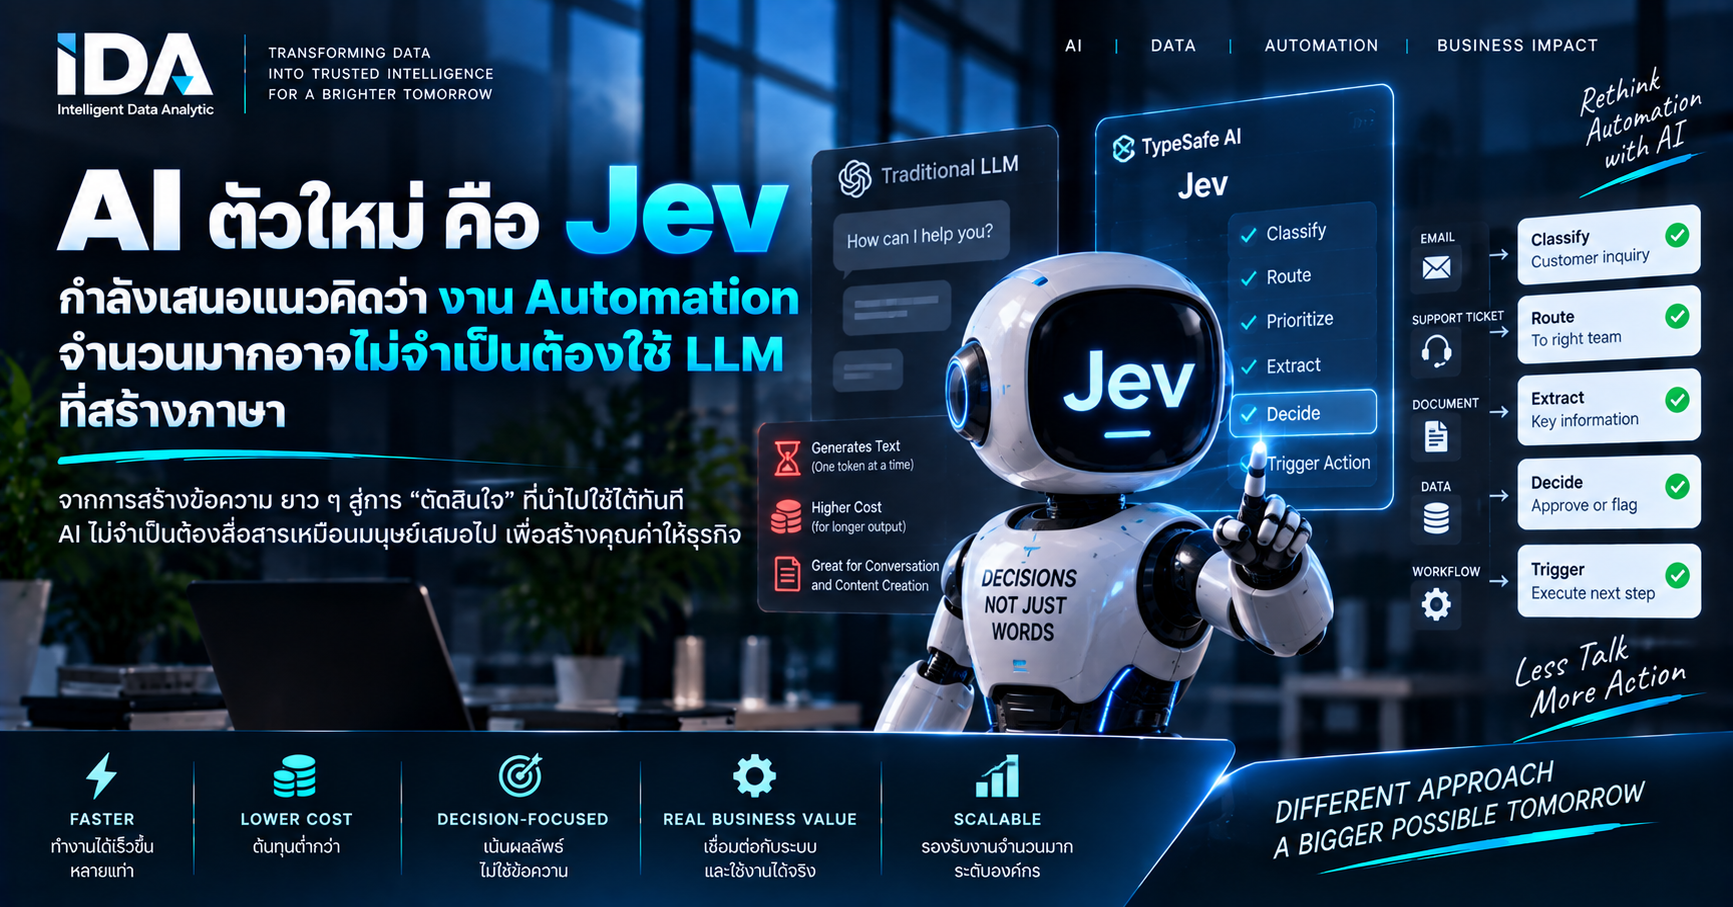
ความแตกต่างสำคัญระหว่าง Jev กับ Large Language Model หรือ LLM ทั่วไป เริ่มต้นจากวิธีที่โมเดลสร้างผลลัพธ์ โดย LLM แบบ Autoregressive จะสร้างคำตอบออกมาทีละ Token และนำ Token ที่เพิ่งสร้างขึ้นไปเป็นส่วนหนึ่งของบริบทสำหรับสร้าง Token ถัดไป กระบวนการนี้จะดำเนินต่อเนื่องไปเรื่อย ๆ จนกว่าคำตอบจะเสร็จสมบูรณ์
นั่นหมายความว่า หากเราต้องการคำตอบที่ยาวขึ้น โมเดลก็ต้องสร้าง Token ต่อเนื่องมากขึ้น แต่ในโลกของ Software งานจำนวนมากไม่ได้ต้องการข้อความยาวเลย
บางครั้งระบบเพียงต้องการคำตอบว่า “ข้อความนี้ควรไป Queue ไหน?”
สิ่งที่ Software ต้องการไม่ใช่ Essay ไม่ใช่บทสนทนา และไม่จำเป็นต้องมีคำอธิบายหลายย่อหน้า แต่ต้องการเพียง Decision ที่สามารถนำไปใช้ใน Workflow ขั้นต่อไปได้ทันที
Parallel Sampler คือหนึ่งในเหตุผลสำคัญ
TypeSafe ระบุว่า Jev ใช้แนวทางที่เรียกว่า parallel sampler และไม่ได้สร้าง String Output แบบเดียวกับ LLM ทำให้สามารถตอบคำถามเชิง Decision หลายรายการจาก State เดียวกันได้อย่างรวดเร็ว
ความแตกต่างนี้มีความสำคัญ เพราะ Jev ไม่จำเป็นต้องเสียทรัพยากรไปกับการสร้างภาษาที่ยาวเกินความต้องการของระบบ หากสิ่งที่ Software ต้องการจริง ๆ เป็นเพียง Category, Score, Boolean หรือ Action หนึ่งรายการ
เร็วกว่า Frontier Models 40–200 เท่าจริงหรือ?
TypeSafe อ้างว่าในงานประเภท System One Tasks บางประเภท Jev สามารถทำงานได้เร็วกว่า Frontier Models ประมาณ 40–200 เท่า และมีต้นทุนต่ำกว่ามาก
บริษัทระบุราคาปัจจุบันไว้ที่ $42 ต่อหนึ่งพันล้าน Input Tokens หรือประมาณ $0.042 ต่อหนึ่งล้าน Input Tokens และไม่มีค่าใช้จ่ายสำหรับ Output Token
แต่ตัวเลข 40–200 เท่าต้องตีความอย่างระมัดระวัง
ตัวเลขดังกล่าวเป็นข้อมูลจาก TypeSafe และขึ้นอยู่กับประเภทของงานและเงื่อนไขที่นำมาเปรียบเทียบ จึงไม่ควรนำไปสรุปอย่างกว้าง ๆ ว่า
“Jev เร็วกว่า GPT หรือ Claude 200 เท่า”
เพราะหากโจทย์คือการเขียนรายงาน วิเคราะห์ปัญหาซับซ้อน เขียน Software หรือสร้าง Content โมเดลเหล่านี้ไม่ได้กำลังทำงานประเภทเดียวกันตั้งแต่ต้น
Jev จะมาแทน ChatGPT, Claude หรือ Gemini หรือไม่?
คำถามนี้อาจไม่ใช่วิธีที่เหมาะที่สุดในการทำความเข้าใจ Jev เพราะโมเดลแต่ละประเภทถูกสร้างขึ้นมาเพื่อแก้ปัญหาที่แตกต่างกัน
หากองค์กรต้องการ AI สำหรับเขียนบทความ สนทนากับลูกค้า อธิบายปัญหาซับซ้อน เขียน Code วิเคราะห์ข้อมูล หรือสรุปรายงาน LLM ยังคงเหมาะกับงานเหล่านี้มากกว่า เพราะความสามารถด้านภาษาและ Reasoning เป็นหัวใจสำคัญของงาน
แต่หากสิ่งที่ระบบต้องการคือการ Classify, Route, Score, Judge, Guardrail หรือเลือก Action จากตัวเลือกที่กำหนดไว้ โมเดลที่ออกแบบมาเพื่อ Decision โดยเฉพาะอาจกลายเป็นอีกทางเลือกหนึ่ง
จาก Jev vs LLM สู่ Jev + LLM + Code
ดังนั้น ภาพอนาคตที่น่าสนใจกว่าการตั้งคำถามว่า “Jev หรือ LLM ใครดีกว่ากัน” คือการมองว่าแต่ละเทคโนโลยีสามารถทำงานร่วมกันอย่างไร
แนวคิดนี้สามารถสรุปได้เป็น
Jev + LLM + Code
โดยแต่ละองค์ประกอบรับผิดชอบงานที่เหมาะสมกับธรรมชาติของตัวเอง
LLM ทำงานที่ต้องใช้ภาษาและ Reasoning
เมื่อระบบต้องทำความเข้าใจบริบทที่ซับซ้อน สร้างคำตอบ อธิบายเหตุผล วิเคราะห์เอกสาร หรือสื่อสารกับมนุษย์ LLM ยังคงมีบทบาทสำคัญ
Decision Model จัดการการตัดสินใจจำนวนมาก
งานที่ต้องจำแนก จัดเส้นทาง ประเมิน หรือเลือก Action ซ้ำ ๆ จำนวนมหาศาล อาจไม่จำเป็นต้องใช้ Frontier LLM ทุกครั้ง
Code ดูแลสิ่งที่ต้องการความแน่นอน
Business Rules ที่สามารถกำหนดอย่างชัดเจนยังคงเหมาะกับ Deterministic Code เพราะองค์กรสามารถควบคุมและตรวจสอบผลลัพธ์ได้ง่ายกว่า
ส่วน Decision ที่มีผลกระทบสูงยังต้องมีมนุษย์
เมื่อการตัดสินใจเกี่ยวข้องกับความเสี่ยงสูง เช่น การเงิน ความปลอดภัย ข้อมูลส่วนบุคคล หรือ Action ที่ย้อนกลับได้ยาก Human Approval ยังคงมีบทบาทสำคัญ
Architecture ของ AI Agent อาจกำลังเปลี่ยน
ลองพิจารณา AI Agent สำหรับ Customer Support ที่ต้องจัดการข้อความลูกค้าหลายหมื่นรายการต่อวัน
หากใช้ Frontier LLM ประมวลผลทุกขั้นตอน ตั้งแต่การจำแนก Intent ประเมินความเสี่ยง เลือก Tool ไปจนถึงการสร้างคำตอบ องค์กรอาจกำลังใช้โมเดลที่มีความสามารถสูงเกินความจำเป็นสำหรับ Decision ขนาดเล็กจำนวนมหาศาล
Hybrid AI Architecture อาจเป็นอีกแนวทางหนึ่ง
ระบบอาจเริ่มจากให้ Jev ทำหน้าที่ Classify Intent จากนั้นประเมิน Risk และเลือก Tool ที่เหมาะสม ก่อนส่งข้อมูลเข้าสู่ Business Rules ที่เขียนด้วย Code
เมื่อถึงขั้นตอนที่ต้องสื่อสารกับลูกค้าหรือสร้างภาษาธรรมชาติ จึงค่อยเรียก LLM เข้ามาสร้าง Response และหากระบบพบว่ากรณีนั้นมีความเสี่ยงสูง จึงส่งต่อให้มนุษย์ตรวจสอบก่อนดำเนิน Action
แนวทางนี้ทำให้ระบบไม่จำเป็นต้องใช้โมเดลขนาดใหญ่กับทุก Decision
Intelligence แต่ละประเภททำงานในสิ่งที่เหมาะกับตัวเอง
สิ่งที่ต้องการภาษาและ Reasoning ใช้ LLM
สิ่งที่ต้องการ Decision จำนวนมากใช้ Decision Model
สิ่งที่ต้องการความแน่นอนใช้ Deterministic Code
ส่วนสิ่งที่มีผลกระทบสูงใช้ Human Approval
นี่คือแนวคิดสำคัญของ Hybrid AI Architecture
แทนที่จะถามว่า “AI Model ตัวไหนเก่งที่สุด?” องค์กรอาจต้องถามใหม่ว่า
“Intelligence แบบไหนเหมาะกับ Decision แต่ละประเภทมากที่สุด?”
Jev กับ Agentic AI อาจเข้ากันได้ดี
ความสัมพันธ์ระหว่าง Jev กับ Agentic AI เป็นอีกพื้นที่หนึ่งที่น่าจับตามอง เพราะ AI Agent ต้องตัดสินใจเล็ก ๆ จำนวนมากตลอด Workflow
Agent อาจต้องพิจารณาว่าควรใช้ Tool ใด ควรค้นข้อมูลเพิ่มเติมหรือไม่ Document ที่พบเกี่ยวข้องกับงานหรือไม่ Email เป็น Spam หรือไม่ Action ที่กำลังจะดำเนินการมีความเสี่ยงสูงหรือไม่ และควร Escalate เรื่องให้มนุษย์ตรวจสอบหรือไม่
คำถามเหล่านี้ส่วนใหญ่ไม่ได้ต้องการ Essay
สิ่งที่ระบบต้องการคือ Decision
เมื่อ Decision เกิดขึ้นนับล้านครั้ง
Decision หนึ่งครั้งอาจดูเหมือนไม่มีความสำคัญในแง่ต้นทุน แต่เมื่อ AI Agent ต้องตัดสินใจหลายล้านครั้งต่อวัน ความแตกต่างของ Latency และ Cost ในแต่ละครั้งจะเริ่มมีผลต่อ Architecture โดยรวมของระบบ
หาก Decision เหล่านี้สามารถดำเนินการได้ด้วย Latency ต่ำและต้นทุนต่ำลง Agent ก็อาจทำงานได้เร็วและมีประสิทธิภาพมากขึ้นอย่างมีนัยสำคัญ
Intelligence Layer ที่มนุษย์อาจไม่เคยเห็น
นี่นำไปสู่แนวคิดที่น่าสนใจว่า AI จำนวนมากในอนาคตอาจไม่ได้ปรากฏอยู่ในรูปของ Chatbot เลย
AI อาจทำงานอยู่เบื้องหลัง Software ทำหน้าที่ตัดสินใจ Routing, Classification และ Risk Assessment อย่างต่อเนื่อง โดยผู้ใช้ไม่จำเป็นต้องรู้ด้วยซ้ำว่ามี AI กำลังทำงานอยู่
Use Case สำหรับองค์กรกว้างกว่า Customer Service
แนวคิดของ Decision Model สามารถนำไปประยุกต์ใช้กับงาน Enterprise ได้หลายประเภท โดยเฉพาะระบบที่มีข้อมูลจำนวนมากและต้องตัดสินใจอย่างรวดเร็ว
Cybersecurity และ Security Operations Center
SOC อาจได้รับ Security Alerts หลายหมื่นรายการต่อวัน ระบบต้องตัดสินใจอย่างต่อเนื่องว่า Alert ใดมีแนวโน้มเป็น False Positive เหตุการณ์ใดควรได้รับ Priority สูง สิ่งใดอาจเป็น Potential Phishing และกรณีใดควรถูก Escalate to Analyst
นี่เป็นตัวอย่างของงานที่ไม่ได้ต้องการบทความหรือคำอธิบายยาวทุกครั้ง แต่ต้องการ Decision ที่รวดเร็วและสามารถส่งต่อเข้าสู่ Security Workflow ได้ทันที
Social Listening และ Reputation Intelligence
ในระบบ Social Listening ข้อมูล Social Conversation สามารถเกิดขึ้นจำนวนมหาศาลในแต่ละวัน ระบบจึงต้องตัดสินใจซ้ำ ๆ ว่าเนื้อหาใดเกี่ยวข้องกับ Brand เป็น Complaint หรือไม่ อยู่ใน Narrative ประเภทใด มี Reputation Risk สูงเพียงใด และควรส่ง Executive Alert หรือไม่
Document Workflow ก็มีลักษณะเดียวกัน
ระบบจัดการเอกสารอาจต้องตัดสินว่าเอกสารเป็นประเภทใด มีข้อมูล Sensitive หรือไม่ ควรส่งให้ฝ่ายใด และต้องผ่าน Human Review ก่อนดำเนินการต่อหรือไม่
ทั้งหมดคือ High-volume, Low-latency Decision Tasks
สิ่งที่ Use Case เหล่านี้มีร่วมกันคือการต้องประมวลผล Decision จำนวนมากด้วยเวลาตอบสนองต่ำ ซึ่งเป็นพื้นที่ที่แนวคิด System One Model ต้องการเข้ามาแก้ปัญหา
Structured Output ไม่ได้หมายความว่าตัดสินใจถูก
นี่เป็นข้อควรระวังที่สำคัญที่สุดข้อหนึ่งสำหรับองค์กร
TypeSafe ใช้คำอธิบายว่า Jev “can’t hallucinate” เนื่องจาก Output Space ถูกกำหนดไว้ล่วงหน้าและโมเดลไม่ได้สร้าง Free-form String แบบ LLM
หากมองในมิติของ Type หรือ Schema แนวคิดนี้มีเหตุผล เพราะระบบไม่สามารถสร้าง Output ที่หลุดออกจากรูปแบบที่กำหนดไว้ได้
แต่สิ่งนี้ไม่ได้หมายความว่า Jev จะไม่ตัดสินใจผิด
Schema Correct ไม่เท่ากับ Decision Correct
สมมติระบบมีตัวเลือกเพียงสองค่า
A = Fraud
และ
B = Normal
Jev อาจคืนค่า B ได้อย่างสมบูรณ์ตาม Schema ทุกประการ แต่ Transaction จริงอาจเป็น Fraud
นี่ไม่ใช่ Schema Hallucination
ในกรณีนี้ระบบไม่ได้สร้างข้อมูลผิดรูปแบบ แต่เกิดสิ่งที่เรียบง่ายกว่าและสำคัญกว่า นั่นคือ
Wrong Decision
สำหรับ Enterprise ความแตกต่างนี้สำคัญมาก
องค์กรจึงไม่ควรตีความคำว่า “ไม่มี Hallucination” ว่าหมายถึง “ไม่มี Error” เพราะ Reliability ของระบบยังขึ้นอยู่กับ Accuracy, Calibration, Data Distribution และเงื่อนไขการใช้งานจริง
Probability ไม่เท่ากับ Truth
อีกเรื่องที่องค์กรต้องระวังคือคำว่า Confidence
หาก AI ระบุว่ามั่นใจ 95% ไม่ได้หมายความโดยอัตโนมัติว่าคำตอบนั้น “ถูก 95%”
ระบบต้องผ่าน Calibration Testing กับข้อมูลจริงขององค์กร
Calibration ต้องพิสูจน์ด้วยข้อมูลจริง
หากมีการตัดสินใจ 1,000 ครั้งที่โมเดลระบุ Confidence ใกล้เคียง 90% และผลลัพธ์จริงถูกต้องประมาณ 900 ครั้งอย่างสม่ำเสมอ เราจึงเริ่มมีหลักฐานว่า Probability ของโมเดลได้รับการ Calibration ที่เหมาะสมกับ Data Distribution นั้น
แต่โลกจริงไม่ได้หยุดนิ่ง
พฤติกรรมลูกค้า รูปแบบ Fraud เทคนิค Cyber Attack และ Narrative บน Social Media สามารถเปลี่ยนแปลงได้ตลอดเวลา เมื่อ Data Distribution เปลี่ยน Calibration ก็สามารถเปลี่ยนตามได้เช่นกัน
Enterprise Deployment จึงต้องเป็นวงจรต่อเนื่อง
การนำ Decision Model มาใช้ใน Production จึงไม่ควรจบลงหลัง Deployment แต่ต้องมีวงจร
Evaluation → Threshold → Monitoring → Human Escalation → Feedback → Re-evaluation
โมเดลไม่ควรถูกเปิดใช้งานแล้วปล่อยทิ้งไว้
หลักการนี้ไม่ได้ใช้เฉพาะกับ Jev แต่เป็นพื้นฐานสำคัญของ Machine Learning และ Enterprise AI Governance โดยทั่วไป
Jev อาจไม่ใช่ AI ที่มาแทน LLM แต่เป็นชิ้นส่วนที่ LLM ขาดอยู่
นี่อาจเป็นมุมมองที่น่าสนใจที่สุดต่อ Jev
ในช่วงหลายปีที่ผ่านมา เราเริ่มใช้ LLM ทำแทบทุกอย่าง ตั้งแต่ Classification, Routing, Moderation, Tool Selection ไปจนถึง Risk Scoring
เหตุผลหนึ่งคือ LLM มีความสามารถกว้างและใช้งานง่าย องค์กรสามารถนำโมเดลเดียวไปประยุกต์กับหลาย Use Case ได้อย่างรวดเร็ว
แต่ความสามารถที่กว้างนั้นอาจแลกมาด้วย Cost, Latency และ Complexity ที่ไม่จำเป็นสำหรับ Decision ขนาดเล็กซึ่งเกิดขึ้นหลายล้านครั้ง
คำถามสำคัญที่ Jev กำลังตั้งขึ้น
Jev กำลังทำให้อุตสาหกรรมต้องกลับมาถามคำถามง่าย ๆ ว่า
เราจำเป็นต้องใช้ AI ที่สามารถเขียน Shakespeare ได้ เพื่อเลือกว่าตั๋ว Support Ticket ควรไป Queue A หรือ Queue B จริงหรือ?
หากคำตอบคือ “ไม่” ตลาด AI อาจเริ่มแยก Intelligence ออกเป็นหลายชั้นมากขึ้น
จาก One Model Does Everything สู่ AI Model Portfolio
สำหรับ Enterprise AI คำถามในอนาคตอาจไม่ได้มีเพียง
“เราจะใช้ OpenAI, Anthropic หรือ Google?”
แต่จะเปลี่ยนไปสู่คำถามที่สำคัญกว่า คือ
“งานแต่ละประเภทควรใช้ Intelligence แบบไหน?”
Right Model for the Right Task
งานที่ต้องการ Reasoning ระดับสูงอาจใช้ Frontier Reasoning Model งานสร้าง Content และการสื่อสารใช้ LLM งานค้นหาและดึงข้อมูลใช้ Retrieval Model งาน Semantic Representation ใช้ Embedding Model งานด้านภาพใช้ Multimodal Model ขณะที่ Decision Routing จำนวนมหาศาลอาจใช้ System One หรือ Decision Model
ส่วน Business Logic ที่ต้องการผลลัพธ์แน่นอนยังคงเหมาะกับ Code และ Action ที่มีความเสี่ยงสูงยังคงต้องมี Human Decision
Architecture จึงเปลี่ยนจาก One Model → Everything
แนวคิดเดิมคือ
One Model → Everything
แต่ Architecture ใหม่อาจเปลี่ยนเป็น
Right Model → Right Task → Right Cost → Right Risk
นี่คือโจทย์ใหม่ของ CIO และ Enterprise Architect
คำถามสำคัญจึงอาจไม่ใช่ว่า AI รุ่นใดมี Benchmark สูงที่สุด แต่คือการออกแบบ Portfolio ของ Intelligence ให้เหมาะสมกับ Performance, Cost, Latency, Reliability, Governance และ Risk ของแต่ละงาน
สิ่งที่ต้องจับตาต่อจาก Jev
Jev เพิ่งเปิดตัวเมื่อวันที่ 15 กันยายน 2026 และยังอยู่ในช่วง Early Access ดังนั้นยังเร็วเกินไปที่จะประกาศว่า System One Models จะกลายเป็นหมวดหมู่ใหม่ของอุตสาหกรรม AI อย่างถาวร
คำว่า System One Model เองก็เป็นคำที่ TypeSafe ใช้อธิบายแนวทางของผลิตภัณฑ์ ขณะที่ Architecture ของ Jev ยังไม่ได้เปิดเผยทั้งหมด Model Weights ไม่ได้เปิด และรายละเอียดเกี่ยวกับ RLCD ยังมีข้อมูลสาธารณะไม่มากพอสำหรับการตรวจสอบอย่างเป็นอิสระเต็มรูปแบบ
Speed, Cost และ Calibration ยังต้องการ Independent Benchmark
ข้อกล่าวอ้างเกี่ยวกับความเร็ว ต้นทุน และ Calibration จึงควรได้รับการตรวจสอบเพิ่มเติมจาก Independent Benchmark และประสบการณ์จาก Production Deployment จริง
สิ่งสำคัญคือการแยก ข้อมูลที่บริษัทผู้พัฒนาเปิดเผย ออกจาก ผลลัพธ์ที่ได้รับการตรวจสอบโดยบุคคลภายนอก
Developer Adoption จะเป็นอีกตัวชี้วัดสำคัญ
หาก Developer เริ่มนำ Decision Model ไปฝังเป็น Intelligence Layer ภายใน Software Automation และสามารถแสดงให้เห็นถึงข้อได้เปรียบด้าน Cost, Latency และ Reliability ใน Production ได้จริง แนวคิดนี้อาจมีผลต่อการออกแบบ AI Systems ในระยะยาว
คำถามจึงไม่ใช่แค่ว่า Jev จะชนะ ChatGPT หรือไม่
คำถามที่น่าสนใจกว่าคือ
“Jev กำลังเปิดตลาดใหม่ของ AI ที่ไม่จำเป็นต้องพูดกับมนุษย์หรือไม่?”
บทสรุป: AI รุ่นต่อไปอาจไม่จำเป็นต้องเป็น Chatbot
ChatGPT ทำให้โลกเห็นว่า AI สามารถสื่อสารกับมนุษย์ได้ ขณะที่ Reasoning Models ทำให้ AI สามารถจัดการกับปัญหาที่ซับซ้อนขึ้น และ Agentic AI กำลังทำให้ AI สามารถใช้ Tools เชื่อมต่อระบบ และดำเนินงานแทนมนุษย์ได้มากขึ้น
Jev กำลังเสนออีกแนวคิดหนึ่ง นั่นคือ AI ที่ไม่จำเป็นต้องพูด
แต่ทำหน้าที่เป็น
Decision Engine inside Software
จาก AI as Chatbot สู่ AI as Intelligence Primitive
หากแนวคิดนี้พิสูจน์ตัวเองได้ใน Production เราอาจกำลังเห็นอีกขั้นหนึ่งของวิวัฒนาการ Enterprise AI
จาก AI as Chatbot ไปสู่ AI as Copilot
จาก AI as Copilot ไปสู่ AI as Agent
และจาก AI as Agent อาจก้าวต่อไปสู่สิ่งที่เรียกว่า
AI as Intelligence Primitive
AI อาจอยู่ทุกที่โดยที่ผู้ใช้ไม่รู้ว่ากำลังใช้ AI
AI ในลักษณะนี้อาจไม่ได้มีหน้าต่าง Chat ให้มนุษย์สนทนาด้วย แต่อาจฝังตัวอยู่ภายใน Software และทำหน้าที่ตัดสินใจหลายล้านครั้งต่อวัน ตั้งแต่ Routing, Classification, Risk Assessment ไปจนถึง Tool Selection โดยผู้ใช้อาจแทบไม่รู้ว่ามี AI ทำงานอยู่เบื้องหลัง
คำถามใหม่สำหรับ Enterprise AI
สำหรับองค์กร คำถามในอนาคตจึงอาจไม่ใช่เพียง
“เราควรใช้ AI Model ตัวไหนดี?”
แต่จะกลายเป็นคำถามว่า
“Decision ไหนควรใช้ LLM, Decision ไหนควรใช้โมเดลอย่าง Jev, Decision ไหนควรใช้ Code และ Decision ไหนต้องให้มนุษย์เป็นคนตัดสิน?”
นี่อาจเป็นจุดที่ Enterprise AI เริ่มเปลี่ยนจากการ ใช้ AI ตัวเดียวทำทุกอย่าง ไปสู่การออกแบบ AI Architecture ที่เลือก Intelligence ให้เหมาะกับแต่ละงาน
และหากแนวคิดนี้เกิดขึ้นจริง การแข่งขันของ AI ในยุคถัดไปอาจไม่ได้วัดกันเพียงว่า ใครสร้างโมเดลที่ฉลาดที่สุด แต่รวมถึงว่าองค์กรใดสามารถนำ Intelligence หลายประเภทมาประกอบเข้าด้วยกัน เพื่อสร้างระบบที่ เร็วกว่า ประหยัดกว่า เชื่อถือได้กว่า และควบคุมความเสี่ยงได้ดีกว่า
เกี่ยวกับผู้เขียน
อาจารย์ปรเมศร์ เพียรสกุล ผู้เชี่ยวชาญด้านความมั่นคงปลอดภัยไซเบอร์ (Cybersecurity) ปัญญาประดิษฐ์ (Artificial Intelligence: AI) และการวิเคราะห์ข้อมูลเชิงกลยุทธ์ ปัจจุบันดำรงตำแหน่งประธานเจ้าหน้าที่บริหาร (Chief Executive Officer: CEO) และผู้ก่อตั้ง บริษัท อินเทลลิเจนท์ ดาต้า อนาไลติก จำกัด โดยมุ่งพัฒนาและประยุกต์ใช้เทคโนโลยี เพื่อเปลี่ยนข้อมูลให้เป็นข่าวกรองที่เชื่อถือได้สำหรับการตัดสินใจของผู้บริหารและองค์กรอย่างมีประสิทธิภาพและยั่งยืน
Poramate Piansakul
Professional Certifications
#JevAI #SystemOneModel #EnterpriseAI #AgenticAI #AIArchitecture
แหล่งอ้างอิงหลัก
TypeSafe AI — Introducing System One Models & Jev
Vercel — Jev is the fastest-adopted model in AI Gateway history
TechCrunch — A new kind of AI model from a ChatGPT inventor is thrilling developers
TypeSafe AI — Jev / System One Models