
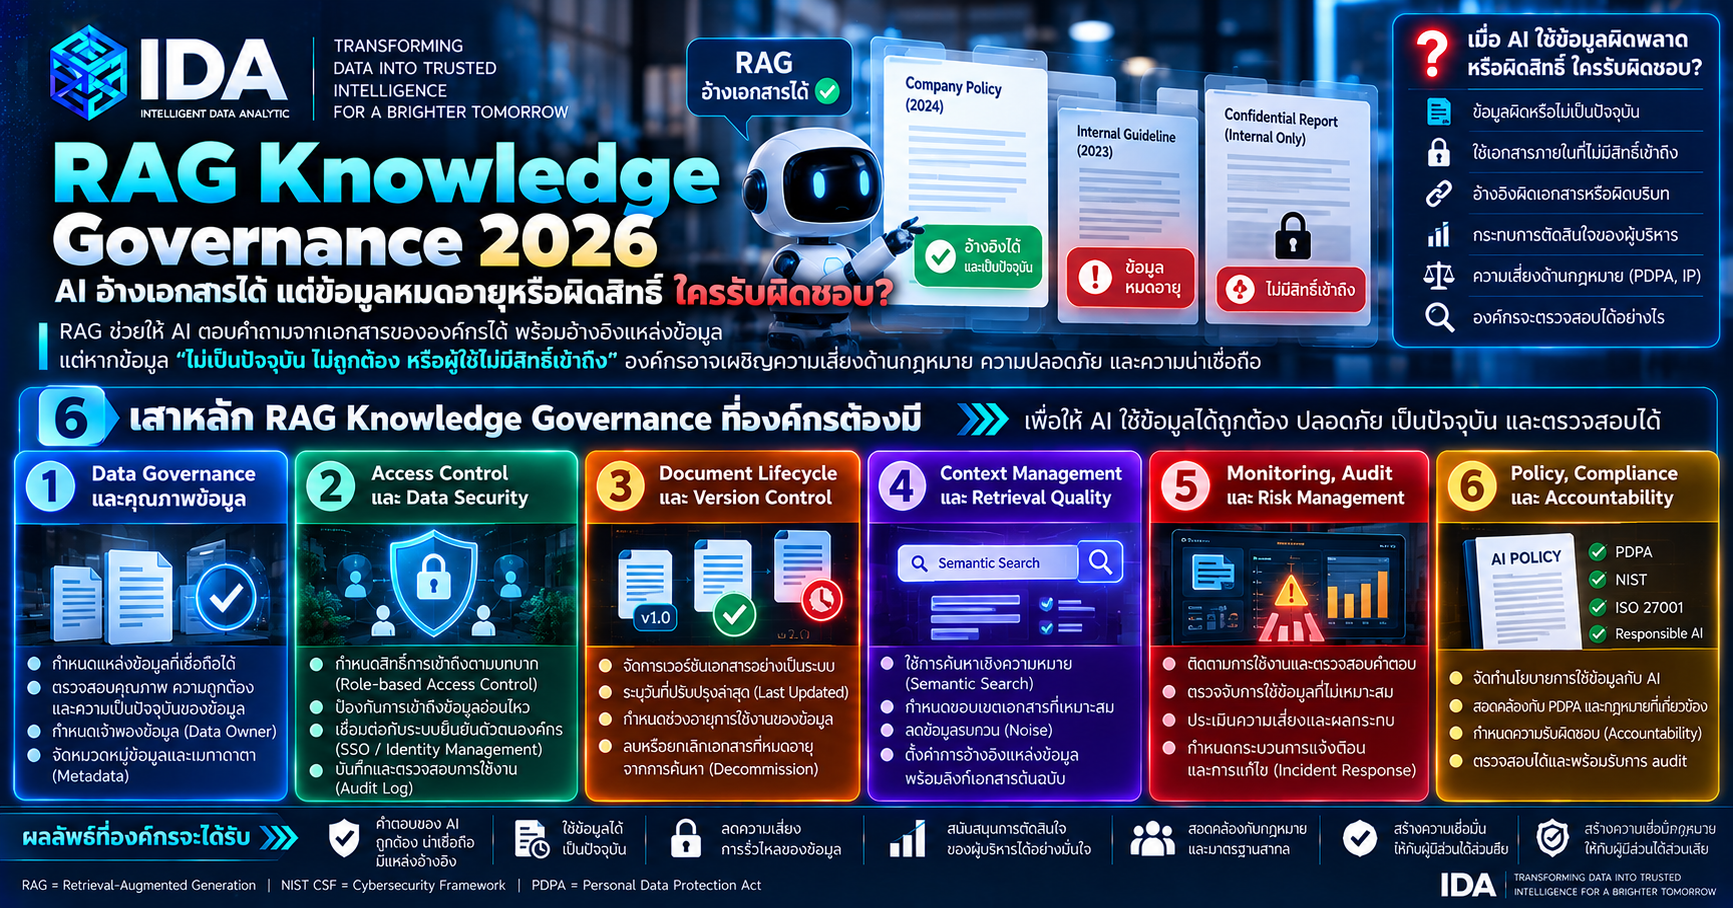
RAG Knowledge Governance 2026: AI อ้างเอกสารได้ แต่ข้อมูลหมดอายุหรือผิดสิทธิ์ ใครรับผิดชอบ?
Key Takeaways
- RAG หรือ Retrieval-Augmented Generation คือระบบที่เชื่อมโมเดล Generative AI กับระบบค้นคืนข้อมูลหรือฐานความรู้ ไม่ได้ทำให้ทุกคำตอบถูกต้องโดยอัตโนมัติ (NIST Glossary)
- องค์กรต้องตรวจทั้งคุณภาพแหล่งข้อมูล วันมีผล เวอร์ชัน สิทธิ์เข้าถึง และความสัมพันธ์ระหว่างข้อความตอบกับหลักฐาน
- Citation หรือรายการอ้างอิงเป็นจุดเริ่มต้นของการตรวจ ไม่ใช่คำรับรองว่าคำตอบใช้ได้กับสถานการณ์ของผู้ถาม
- การลบเอกสารต้นทางต้องมีวิธีติดตามผลถึงดัชนีค้นหา สำเนา Cache และคำตอบที่บันทึกไว้
- บทความเสนอแนวทางควบคุมฐานความรู้และการทดสอบสำหรับผู้บริหาร ทีมข้อมูล และทีมสื่อสารองค์กร โดยไม่อ้างผลลัพธ์ลูกค้าจริงของ IDA
บทนำ: เมื่อคำตอบที่ดูน่าเชื่อถือใช้เอกสารผิดฉบับ
เมื่อองค์กรนำ AI มาช่วยตอบคำถามภายใน พนักงานอาจถามเรื่องนโยบายค่าใช้จ่าย ทีมขายอาจถามเงื่อนไขสินค้า และเจ้าหน้าที่อาจถามขั้นตอนให้บริการประชาชน ความสะดวกของ Chatbot ทำให้ผู้ใช้เห็นคำตอบพร้อมลิงก์เอกสารแล้วเชื่อว่า “ระบบค้นจากข้อมูลองค์กร จึงน่าจะถูกต้อง”
แต่ฐานความรู้อาจมีประกาศเก่า เอกสารร่าง และคู่มือคนละหน่วยงานปะปนกัน คำตอบที่อ่านคล่องและมี Citation จึงอาจยังไม่เหมาะกับการตัดสินใจ หากไม่ตรวจว่าเอกสารมีผลเมื่อใด ใช้กับใคร และผู้ถามมีสิทธิ์เห็นรายละเอียดนั้นหรือไม่
ประเด็นนี้เกี่ยวข้องกับการขยาย AI จากงานร่างข้อความไปสู่การให้บริการและสนับสนุนการตัดสินใจในปี 2569 บทความวันนี้จึงเน้น Knowledge Governance หรือการกำกับฐานความรู้ ต่างจากการตรวจภาษาและคุณภาพบทความก่อนเผยแพร่ เพราะเป้าหมายคือทำให้ AI ใช้เอกสารที่ถูกฉบับ ถูกเวลา และถูกสิทธิ์
หลักฐานจาก NIST: RAG ยังต้องรับมือความเสี่ยงหลายด้าน
NCCoE ของ NIST พัฒนาต้นแบบ Chatbot สำหรับค้นและสรุปแนวทาง Cybersecurity ภายใน โดยใช้ RAG ร่วมกับแหล่งความรู้ รายงาน NIST IR 8579 Initial Public Draft ที่เผยแพร่วันที่ 31 กรกฎาคม 2568 กล่าวถึง Prompt Injection, Hallucinations, Data Exposure และ Unauthorized Access รวมถึงมาตรการที่ใช้ในต้นแบบ เช่น Local Deployment, Access Controls และ Validation Filters
สถานะที่ต้องเข้าใจ: รายงานนี้เป็นการบันทึกการตัดสินใจ ข้อจำกัด และมาตรการของต้นแบบ ณ เวลาหนึ่ง NIST ระบุว่าไม่ได้จัดทำเป็นคู่มือ Implementation และหน้าเผยแพร่ที่ตรวจสอบวันที่ 10 ตุลาคม 2569 ยังคงแสดงสถานะ Initial Public Draft (NIST IR 8579)
ข้อเสนอในบทความนี้จึงเป็นแนวทางประยุกต์สำหรับองค์กร ไม่ใช่การอ้างว่า NIST รับรองสถาปัตยกรรมของ IDA หรือรับประกันว่าระบบ RAG จะปลอดภัย
แยกความถูกต้อง 4 ชั้นก่อนวัดคุณภาพคำตอบ
| ชั้นที่ต้องตรวจ | คำถามหลัก | ตัวอย่างความผิดพลาด |
| Source Validity | เอกสารได้รับอนุมัติและยังมีผลหรือไม่ | ค้นพบคู่มือเก่าแต่ไม่พบประกาศยกเลิก |
| Access Validity | ผู้ใช้มีสิทธิ์เห็นข้อมูลหรือไม่ | พนักงานทั่วไปได้รับรายละเอียดฝ่ายบุคคล |
| Retrieval Relevance | ส่วนที่ค้นมาตรงกับคำถามหรือไม่ | ใช้ข้อยกเว้นของอีกหน่วยงานมาตอบ |
| Answer Support | ข้อความตอบมีหลักฐานรองรับจริงหรือไม่ | อ้างเอกสารที่เกี่ยวข้องแต่ไม่มีเงื่อนไขที่ตอบ |
การแยกเช่นนี้ช่วยให้ทีมแก้ถูกจุด หากปัญหาอยู่ที่ทะเบียนเอกสาร การเปลี่ยนโมเดลอย่างเดียวอาจไม่ช่วย หากปัญหาอยู่ที่สิทธิ์ การเพิ่มคำสั่งให้โมเดล “ห้ามเปิดเผย” ก็ไม่ทดแทนการควบคุมการค้นคืนข้อมูล
6 แนวทางออกแบบฐานความรู้ที่องค์กรควบคุมได้
1. ระบุเจ้าของและสถานะก่อนนำเข้า
เอกสารแต่ละรายการควรมี Document ID, Owner, Approver, Version, Status, Effective Date และ Review Date โดยแยก Draft, Approved, Superseded และ Withdrawn ให้ชัดเจน หากไม่มีเจ้าของข้อมูล จะไม่มีผู้รับผิดชอบเมื่อเนื้อหาเปลี่ยนหรือเกิดข้อขัดแย้ง
ควรเลือกเอกสาร Approved ที่ตรงกับวัตถุประสงค์ของ Pilot ก่อน ไม่ควรเริ่มด้วยการนำไฟล์ทั้งหมดเข้าสู่ฐานความรู้เพียงเพราะมีพื้นที่จัดเก็บเพียงพอ
2. เก็บบริบทเมื่อแบ่งเอกสารเป็นส่วนย่อย
Chunking คือการแบ่งเอกสารเพื่อช่วยค้นคืน แต่ส่วนย่อยต้องยังระบุได้ว่ามาจากเอกสารใด หน้าใด และหัวข้อใด ตารางอาจมีหมายเหตุที่เปลี่ยนความหมาย ส่วนเงื่อนไขอาจอยู่ก่อนหรือหลังข้อความที่ค้นพบ
ข้อเสนอคือทดสอบการแบ่งเอกสารกับคำถามที่ต้องอ่านข้ามหน้า รวมถึงเอกสารสแกน ตาราง และภาคผนวก ไม่ใช้ขนาด Chunk เดียวเป็นข้อสรุปว่าคุณภาพเหมาะกับทุกเอกสาร
3. บังคับสิทธิ์ก่อนส่งข้อมูลเข้าโมเดล
ระบบควรกรองเอกสารตามสิทธิ์ผู้ใช้ ณ จุดค้นคืน และตรวจซ้ำในขั้นตอนที่เกี่ยวข้อง ไม่ดึงข้อมูลลับเข้า Context แล้วหวังว่าโมเดลจะไม่พูดออกมา
ต้องทดสอบทั้งคำถามตรง คำถามอ้อม การอ้างบทสนทนาเก่า และการสรุปรวมหลายเอกสาร เพราะข้อมูลอาจเปิดเผยโดยไม่แสดงข้อความต้นฉบับทั้งหมด เช่น การยืนยันว่ามีพนักงานอยู่ในรายชื่อที่จำกัดสิทธิ์
4. กำหนดวิธีตอบเมื่อหลักฐานขัดกัน
หากเอกสารสองฉบับมีเงื่อนไขต่างกัน ระบบไม่ควรเลือกฉบับที่ค้นได้คะแนนสูงสุดแล้วตอบอย่างมั่นใจ ควรใช้กฎด้านอำนาจอนุมัติ วันมีผล และขอบเขต พร้อมส่งต่อผู้รับผิดชอบเมื่อยังสรุปไม่ได้
คำตอบ “พบข้อมูลขัดแย้ง ต้องให้เจ้าของนโยบายยืนยัน” เป็นผลลัพธ์ที่เหมาะสมในบางกรณี ผู้บริหารจึงควรยอมรับ Abstention หรือการงดตอบเมื่อหลักฐานไม่พอ เป็นส่วนหนึ่งของคุณภาพระบบ
5. ตรวจ Citation ระดับข้อกล่าวอ้าง
การแสดงลิงก์ท้ายคำตอบไม่พอ ควรตรวจว่าข้อกล่าวอ้างแต่ละส่วนมีข้อความต้นทางรองรับหรือไม่ และหลักฐานนั้นมีข้อยกเว้นหรือเงื่อนไขที่ตกหล่นหรือไม่
สำหรับคำตอบที่มีผลต่อสิทธิประโยชน์ เงิน ความปลอดภัย หรือชื่อเสียง ควรให้ผู้ใช้เปิดดูแหล่งต้นทางและส่งต่อผู้มีอำนาจได้สะดวก ไม่ทำให้หน้าจอแสดงความมั่นใจเกินสถานะหลักฐาน
6. ออกแบบการถอนข้อมูลและทบทวนย้อนหลัง
เมื่อเอกสารถูกถอน ทีมต้องรู้ว่าข้อมูลถูกนำไปสร้างดัชนีหรือสำเนาใด และจะตรวจว่าคำถามเดิมไม่เรียกข้อมูลนั้นกลับมาได้อย่างไร การจัดการ Cache, Logs และประวัติคำตอบต้องพิจารณาวัตถุประสงค์และนโยบายเก็บข้อมูลแยกกัน
ควรมี Withdrawal Test หรือการทดสอบถอนเอกสาร รวมถึงการเปลี่ยนสิทธิ์ผู้ใช้หลังเคยเข้าถึงข้อมูล เพื่อประเมินว่าระบบยังเผยข้อมูลผ่าน Session หรือ Cache หรือไม่
ตัวอย่างประยุกต์: AI ช่วยทีมบริการลูกค้าตอบเงื่อนไขการรับประกัน
สถานการณ์จำลอง ไม่ใช่ผลงานจริงของ IDA: บริษัทมีคู่มือรับประกันหลายรุ่นสินค้า พร้อมเงื่อนไขตามวันซื้อและช่องทางขาย ทีมบริการใช้ RAG ช่วยค้นคำตอบ
หากผู้ใช้ถามว่า “สินค้ารุ่นนี้เคลมได้หรือไม่” ระบบควรถามข้อมูลจำเป็น เช่น รุ่น วันซื้อ และลักษณะปัญหา จากนั้นค้นเฉพาะเอกสารที่มีผลกับกรณีนั้น พร้อมแสดงหลักฐานและข้อยกเว้น การมีชื่อรุ่นใกล้เคียงไม่เพียงพอให้ตัดสินสิทธิ์แทนเจ้าหน้าที่
ทีมการตลาดสามารถนำคำถามที่พบซ้ำไปปรับหน้า FAQ ส่วนทีมข้อมูลตรวจจุดที่ Retrieval ผิด และทีมสื่อสารติดตามว่าลูกค้าสับสนกับเงื่อนไขใด ข้อมูลจาก Blue Eye Social Listening อาจช่วยระบุประเด็นสาธารณะที่ควรตรวจ แต่ไม่ควรถูกนำเข้าเป็นนโยบายรับประกันที่ได้รับอนุมัติ
แนวคิดเดียวกันใช้กับหน่วยงานรัฐที่ให้ข้อมูลสิทธิประโยชน์ได้ โดยแยกบทบาทการช่วยค้นและอธิบาย ออกจากอำนาจตัดสินสิทธิ์จริง
เริ่ม Pilot อย่างไรใน 30 วัน
สัปดาห์แรก: เลือกคำถามธุรกิจหนึ่งกลุ่ม แต่งตั้งเจ้าของฐานความรู้ และตรวจเอกสารที่จะนำเข้า สร้างรายการสิ่งที่ระบบทำได้และต้องส่งต่อคน
สัปดาห์ที่สอง: จัด Metadata, Version และ Access Rules พร้อมสร้างชุดคำถามจากงานจริง รวมคำถามที่ไม่มีคำตอบและคำถามที่ต้องใช้ข้อมูลหลายฉบับ
สัปดาห์ที่สาม: ทดสอบ Retrieval, Citation, Permissions, Conflict และ Withdrawal แยกจากการประเมินภาษาคำตอบ เก็บรายละเอียดว่าข้อผิดพลาดเกิดที่ชั้นใด
สัปดาห์ที่สี่: ให้ผู้ใช้กลุ่มจำกัดทดลอง เก็บ Feedback และตัดสินใจว่าจะขยาย แก้ไข หรือหยุด โดยอิงหลักฐาน ไม่ใช่ความประทับใจจาก Demo
ระยะเวลาเหล่านี้เป็นแผนเสนอสำหรับ Pilot ขนาดจำกัด ไม่ใช่คำรับประกันส่งมอบ และอาจต้องขยายเมื่อข้อมูลซับซ้อนหรือสิทธิ์เข้าถึงมีหลายระดับ
KPI และ Checklist ก่อนเปิดใช้
KPI ควรวัด Retrieval Relevance, Claim Support, การใช้เอกสารปัจจุบัน, Unauthorized Disclosure, เวลาอัปเดตหลังนโยบายเปลี่ยน และอัตราส่งต่อที่เหมาะสม โดยกำหนดวิธีสุ่มตรวจและตัวหารให้ชัดเจน Accuracy รวมตัวเดียวอาจซ่อนข้อผิดพลาดร้ายแรงในคำถามกลุ่มเล็ก
- ☐ มีเจ้าของฐานความรู้และเจ้าของคำตอบ
- ☐ เอกสารมี Status, Version และ Effective Date
- ☐ ทดสอบข้อมูลหมดอายุและเอกสารที่ถูกแทนที่
- ☐ ตรวจสิทธิ์ก่อนข้อมูลเข้า Context
- ☐ ทดสอบการเปลี่ยนสิทธิ์และ Session เดิม
- ☐ Citation เปิดกลับไปยังตำแหน่งต้นทางได้
- ☐ มีวิธีจัดการข้อยกเว้นและหลักฐานขัดแย้ง
- ☐ ระบบงดตอบหรือถามเพิ่มได้
- ☐ ทดสอบเอกสารสแกน ตาราง และภาคผนวก
- ☐ มี Withdrawal Test และผู้อนุมัติการถอน
- ☐ Logs จำกัดสิทธิ์และมีนโยบายเก็บข้อมูล
- ☐ มี Human Handoff สำหรับการตัดสินใจที่มีผลสูง
- ☐ KPI แยกการค้นคืนออกจากการสร้างคำตอบ
- ☐ มีชุดทดสอบก่อนเปลี่ยนโมเดลหรือดัชนี
- ☐ ผู้บริหารเห็นข้อจำกัดและความเสี่ยงคงเหลือก่อนอนุมัติ
บทสรุป
RAG ทำให้ AI เข้าถึงความรู้ขององค์กรได้สะดวกขึ้น แต่ความรับผิดชอบยังอยู่ที่การเลือกและควบคุมความรู้ รวมถึงการตรวจว่าคำตอบมีหลักฐานที่เหมาะกับผู้ถามและเวลาที่ถาม
จุดเริ่มต้นที่มีคุณค่าคือฐานความรู้ขนาดจำกัดที่มีเจ้าของ เวอร์ชัน สิทธิ์ และวิธีถอนข้อมูลชัดเจน เมื่อพิสูจน์กระบวนการได้แล้วจึงขยายตามความพร้อมขององค์กร
เชื่อมความรู้กับการตัดสินใจที่ตรวจสอบได้กับ IDA
IDA ให้บริการ Data & Analytics, AI Services, Digital Intelligence & Reputation และ Graphic & Multimedia พร้อมเทคโนโลยี Social Listening ตามบริบทบริการบนเว็บไซต์ (บริการ IDA, เทคโนโลยี)
องค์กรสามารถเริ่มหารือจากโจทย์ฐานความรู้หนึ่งกลุ่ม เพื่อออกแบบ Data Inventory, Metadata, RAG Workflow, Evaluation และการสื่อสารข้อจำกัดแก่ผู้ใช้ ส่วน Blue Eye Social Listening ใช้เป็นข้อมูลบริบทภายนอกที่ต้องตรวจสอบก่อนเปลี่ยนเป็นความรู้ที่องค์กรรับรอง แนวทางนี้เชื่อมกับ Transform Data into Intelligence, Insights & Impact (IDA)
แหล่งอ้างอิงและข้อจำกัด
- Retrieval-Augmented Generation — Glossary. ไม่ระบุวันเผยแพร่บนหน้า
- Developing the NCCoE Chatbot: Technical and Security Learnings from the Initial Implementation, IR 8579 Initial Public Draft. เผยแพร่ 31 กรกฎาคม 2568; เป็นร่างและรายงานต้นแบบ ไม่ใช่คู่มือ Implementation
- หน้าแรก, เกี่ยวกับเรา, บริการ, เทคโนโลยี, Insight Hub. ไม่ระบุวันเผยแพร่ของหน้ารวม
#RAG #KnowledgeGovernance #AIGovernance #DataGovernance #IDAThailand




