
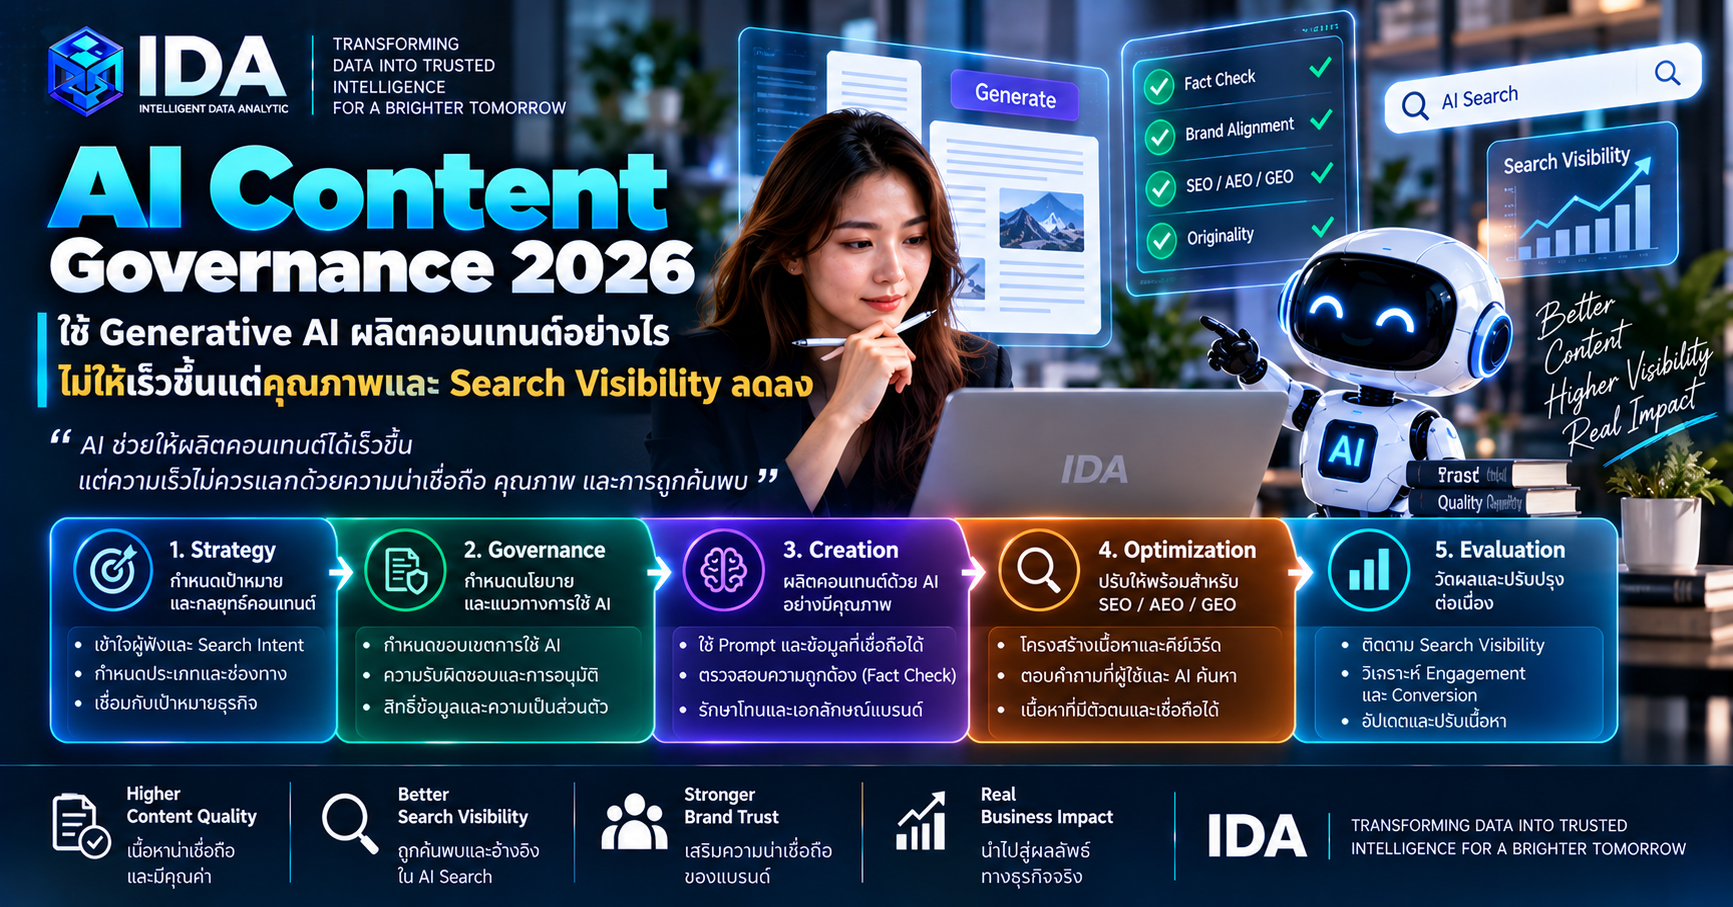
AI Content Governance 2026: ใช้ Generative AI ผลิตคอนเทนต์อย่างไร ไม่ให้เร็วขึ้นแต่คุณภาพและ Search Visibility ลดลง
ประเภท: Blog สำหรับเว็บไซต์ Intelligent Data Analytic (IDA)
วันที่ร่าง: 9 ตุลาคม 2569
กลุ่มผู้อ่าน: ผู้บริหาร นักการตลาด ทีมข้อมูล ทีมสื่อสารองค์กร และหน่วยงานรัฐ
Key Takeaways
- Google ปรับคำแนะนำเรื่องคอนเทนต์ที่ใช้ Generative AI เมื่อ 1 ตุลาคม 2569 โดยย้ำเรื่องความถูกต้อง คุณภาพ ความเกี่ยวข้อง การตรวจโดยมนุษย์ และคุณค่าที่เพิ่มให้ผู้ใช้ ไม่ได้ระบุว่า “ใช้ AI แล้วผิดนโยบาย” โดยอัตโนมัติ (Google Search Central, 1 ต.ค. 2569)
- ความเสี่ยงสำคัญคือ Scaled Content Abuse: การสร้างหลายหน้าเพื่อควบคุมอันดับ โดยเป็นเนื้อหาที่ไม่เป็นต้นฉบับและแทบไม่เพิ่มคุณค่า ไม่ว่าผลิตด้วย AI มนุษย์ หรือทั้งสองแบบ (Google Spam Policies)
- Human Review ต้องตรวจทั้งข้อความ, Title, Meta Description, Structured Data และ Alt Text ไม่ใช่เพียงอ่านคำผิดก่อนกดเผยแพร่ (Google: Using Generative AI Content)
- ความเร็วในการผลิตเป็นเพียง Operational Metric; ผู้บริหารควรวัด Verified Value per Published Asset ควบคู่กับ Correction Rate, Source Coverage และ Conversion ที่ตรวจสอบได้
- บทความนี้เสนอกรอบ PROOF-7 สำหรับกำกับ AI Content Pipeline ซึ่งเป็นข้อเสนอเชิงปฏิบัติของ IDA ไม่ใช่มาตรฐานหรือระบบจัดอันดับของ Google
บทนำ: ปัญหาไม่ใช่ “AI เขียนหรือไม่” แต่คือ “องค์กรเพิ่มคุณค่าและรับผิดชอบหรือไม่”
Generative AI ทำให้ทีมการตลาดร่างบทความ คำบรรยายสินค้า FAQ และโพสต์โซเชียลได้เร็วขึ้น แต่ความเร็วสร้างแรงจูงใจให้วัดผลด้วยจำนวนชิ้น จำนวนคำ หรือจำนวนหน้าที่เผยแพร่ เมื่อ KPI ให้รางวัลกับปริมาณมากกว่าคุณค่า องค์กรอาจได้ “โรงงานคอนเทนต์” ที่ประหยัดเวลาร่าง แต่เพิ่มภาระตรวจแก้ สร้างข้อมูลซ้ำ และลดความน่าเชื่อถือของแบรนด์
วันที่ 1 ตุลาคม 2569 Google Search Central ระบุว่าได้ปรับคู่มือการใช้ Generative AI Content ให้สอดคล้องกับ Search Quality Raters Guidelines มากขึ้น คู่มือยอมรับว่า AI มีประโยชน์ต่อการค้นคว้าและจัดโครงสร้างคอนเทนต์ แต่เตือนว่าการสร้างหลายหน้าโดยไม่เพิ่มคุณค่าอาจเข้าข่าย Scaled Content Abuse พร้อมย้ำให้ตรวจข้อเท็จจริงด้วยมนุษย์ก่อนเผยแพร่ (Google Search Central)
ข้อสรุปสำหรับผู้บริหารจึงไม่ใช่ “ห้าม AI” หรือ “เร่งใช้ AI ให้มากที่สุด” แต่คือการออกแบบกระบวนการที่ตอบได้ว่า ใครรับผิดชอบข้อกล่าวอ้าง หลักฐานอยู่ที่ใด สิ่งใดเป็นมุมมองต้นฉบับ และจะหยุดหรือแก้คอนเทนต์อย่างไรเมื่อข้อมูลเปลี่ยน
Google เปลี่ยนอะไร และไม่ได้บอกอะไร
ข้อเท็จจริงจากคำแนะนำล่าสุด
Google ระบุให้เน้น Accuracy, Quality และ Relevance โดยอธิบายว่าโมเดลสร้างข้อความจากความน่าจะเป็น จึงอาจให้ข้อมูลคลาดเคลื่อน นอกจากนี้การตรวจต้องครอบคลุม Metadata เช่น <title>, Meta Description, Structured Data และ Alt Text เพราะองค์ประกอบเหล่านี้อาจปรากฏในผลการค้นหา (Google, เข้าถึง 9 ต.ค. 2569)
Google ยังระบุว่า การให้บริบทเกี่ยวกับวิธีสร้างคอนเทนต์อาจช่วยผู้อ่านเข้าใจที่มา โดยให้เลือกเปิดเผยในแบบที่เหมาะกับผู้ชม อย่างไรก็ตาม ข้อความนี้ไม่ใช่กฎทั่วไปว่าทุกบทความที่มี AI ช่วยต้องติดป้ายรูปแบบเดียวกัน
Search Quality Raters Guidelines ก็ไม่ใช่ “สูตรลับจัดอันดับ” Google อธิบายชัดว่า Rater ใช้ประเมินประสิทธิภาพของระบบ และคะแนนของ Rater ไม่ได้เปลี่ยนอันดับหน้าเว็บโดยตรง (Google People-first Content)
สิ่งที่ไม่ควรสรุปเกินหลักฐาน
- ไม่ควรอ้างว่า Google ลงโทษทุกคอนเทนต์ที่ใช้ AI
- ไม่ควรอ้างว่ามีจำนวนคำหรือสัดส่วน Human/AI ที่รับประกันอันดับ
- ไม่ควรถือว่า Citation จำนวนมากเท่ากับ Original Value
- ไม่ควรอ้างว่า Structured Data หรือการติดป้าย AI จะรับประกัน Index, Ranking หรือ Citation ใน AI Search
- ไม่ควรตีความ Traffic ที่เพิ่มขึ้นว่าเกิดจาก AI Content โดยตรง หากไม่มีการออกแบบการวัดเชิงเหตุและผล
จาก Content Automation สู่ Content Evidence Pipeline
องค์กรควรแยกอย่างน้อยสี่ชั้นให้ชัด:
- Source Layer — เอกสารต้นทาง ข้อมูลภายใน งานวิจัย กฎหมาย และวันที่เข้าถึง
- Generation Layer — Prompt, Model, Version และคำสั่งที่ใช้ร่างหรือแปลงรูปแบบ
- Editorial Layer — ผู้เชี่ยวชาญตรวจข้อเท็จจริง สิทธิ์ ภาษา ความเหมาะสม และผลกระทบ
- Measurement Layer — Search Visibility, Engagement, Conversion, Correction และ Reputation Signal
ถ้าเก็บเพียงไฟล์สุดท้าย องค์กรจะตอบย้อนหลังได้ยากว่า ข้อความใดมาจากหลักฐานใด ใครอนุมัติ และ Metadata ถูกแก้พร้อมเนื้อหาหรือไม่
Framework PROOF-7: 7 จุดควบคุมก่อนเผยแพร่คอนเทนต์ที่มี AI ช่วย
1. Purpose — กำหนดวัตถุประสงค์และผู้รับสาร
ระบุว่าคอนเทนต์ช่วยผู้อ่านตัดสินใจเรื่องใด และเหตุใดองค์กรจึงมีความเหมาะสมที่จะพูดเรื่องนั้น หากหัวข้อถูกเลือกเพียงเพราะมี Search Volume แต่ไม่สัมพันธ์กับความเชี่ยวชาญหรือผู้ชมเดิม เป็นสัญญาณให้ทบทวน
2. References — ผูกข้อกล่าวอ้างกับแหล่งต้นทาง
สร้าง Claim–Source Map สำหรับตัวเลข วันที่ กฎหมาย คุณสมบัติสินค้า และคำแนะนำที่มีผลสูง แยก Primary Source ออกจากข่าวสรุป และบันทึกวันที่เข้าถึง เพราะหน้าเว็บและข้อกำหนดเปลี่ยนได้
3. Original Value — เพิ่มสิ่งที่หาไม่ได้จากการสรุปทั่วไป
เพิ่มข้อมูลจากผู้เชี่ยวชาญ ประสบการณ์จริง วิธีวิเคราะห์ Framework, Checklist, Comparison หรือข้อมูลที่องค์กรมีสิทธิ์ใช้ Google แนะนำ Non-commodity Content ที่มีมุมมองและประสบการณ์เฉพาะ มากกว่าการเรียบเรียงสิ่งที่มีอยู่แล้ว (Google AI Optimization Guide)
4. Oversight — ตรวจโดยผู้มีความรู้และอำนาจแก้
Reviewer ต้องปฏิเสธการเผยแพร่ได้ และควรแยกการตรวจ Fact, Legal/Privacy, Brand Voice และ Accessibility ตามระดับความเสี่ยง การกด Approve โดยไม่เห็นแหล่งอ้างอิงไม่ถือเป็นการตรวจสาระ
5. Footprint — ตรวจทั้งหน้าก่อนเผยแพร่
ตรวจข้อความ รูปภาพ Caption, Title, Meta Description, Canonical, Structured Data, Alt Text, Internal Link และวันที่เผยแพร่พร้อมกัน เพื่อป้องกันกรณีเนื้อหาถูกต้องแต่ Metadata ยังกล่าวอ้างเกินจริง
6. Feedback — วัดผลและรับสัญญาณแก้ไข
เชื่อม Search Console, Web Analytics, Conversion และ Social Listening เพื่อดูว่าเนื้อหาถูกค้นพบ เข้าใจ และพูดถึงอย่างไร Social Signal ช่วยพบความสับสนหรือ Reputation Risk แต่ไม่ใช่หลักฐานว่าเนื้อหาทำให้เกิดยอดขายหรือวิกฤตโดยลำพัง
7. Fix/Retire — แก้ ถอน หรือทบทวนตามเวลา
กำหนด Content Owner, Review Date, Correction Log และเกณฑ์ถอนหน้า โดยเฉพาะข้อมูลกฎหมาย ราคา นโยบาย ความปลอดภัย และสุขภาพ การเปลี่ยนวันที่หน้าเว็บโดยไม่ปรับสาระไม่ใช่การทำให้คอนเทนต์สดใหม่
ตัวอย่างการประยุกต์ใช้: ศูนย์ข้อมูลสิทธิประโยชน์ของหน่วยงานรัฐ
สมมติหน่วยงานรัฐใช้ AI ช่วยร่างหน้าอธิบายสิทธิประโยชน์หลายประเภท เป้าหมายคือช่วยประชาชนเข้าใจเงื่อนไข ไม่ใช่เพิ่มจำนวนหน้าที่ Index
กระบวนการที่เหมาะสมคือ เจ้าของนโยบายระบุคำถามจริง → ทีมข้อมูลสร้าง Claim–Source Map จากประกาศทางการ → AI ช่วยทำร่างและภาษาที่อ่านง่าย → ผู้เชี่ยวชาญตรวจเงื่อนไขและข้อยกเว้น → ทีมเว็บตรวจ Metadata และ Accessibility → เผยแพร่พร้อมวันมีผลและช่องทางติดต่อ → ติดตามคำค้นและข้อร้องเรียน → แก้หรือถอนเมื่อประกาศเปลี่ยน
ตัวชี้วัดควรรวมอัตราคำถามที่ผู้ใช้แก้ได้สำเร็จ, จำนวน Correction หลังเผยแพร่, ระยะเวลาจากนโยบายเปลี่ยนถึงหน้าเว็บได้รับการแก้ และสัดส่วนข้อกล่าวอ้างสำคัญที่มีแหล่งต้นทาง ไม่ใช่นับเพียงจำนวนหน้าที่ AI ผลิตได้
KPI ที่ควรแทน “จำนวนบทความต่อเดือน”
การเพิ่ม Output อาจมีประโยชน์ต่อ Capacity Planning แต่ไม่ควรถูกใช้เป็นหลักฐานว่าคอนเทนต์สร้างคุณค่า คณะทำงานควรสร้าง Baseline ก่อนใช้ AI และติดตามอย่างน้อยสี่มิติ
| มิติ | KPI ตัวอย่าง | สิ่งที่ KPI ยังพิสูจน์ไม่ได้ |
|---|---|---|
| Evidence | สัดส่วนข้อกล่าวอ้างสำคัญที่มี Primary Source | แหล่งอ้างอิงนั้นตีความถูกต้องหรือไม่ |
| Quality | Correction Rate, Retraction Rate, Reviewer Rejection Rate | อันดับ Search จะเพิ่มขึ้นหรือไม่ |
| User Value | Task Completion, Qualified Engagement, Return Visit | AI Content เป็นสาเหตุของผลลัพธ์โดยลำพัง |
| Operations | Time to Verified Publish, Review Backlog | การผลิตเร็วขึ้นคุ้มต้นทุนรวมแล้วหรือไม่ |
| Reputation | จำนวนประเด็นสับสนที่ยืนยันแล้วและเวลาแก้ไข | Mention หรือ Sentiment เป็นเหตุให้ยอดขายเปลี่ยน |
คำว่า Verified Value per Published Asset ในบทความนี้หมายถึงผลลัพธ์ที่นิยามล่วงหน้าและมีหลักฐานรองรับ หารด้วยจำนวนชิ้นที่ผ่าน Gate ครบ ไม่ใช่คะแนนมาตรฐานสากล องค์กรควรกำหนดสูตรให้สอดคล้องกับงาน เช่น Qualified Lead สำหรับภาคธุรกิจ หรือ Successful Information Task สำหรับบริการประชาชน พร้อมรายงานช่วงความไม่แน่นอนและข้อจำกัดของ Attribution
Checklist 15 ข้อก่อนกด Publish
- ระบุ Audience, Purpose และ Content Owner
- หัวข้อสอดคล้องกับความเชี่ยวชาญขององค์กร
- ข้อกล่าวอ้างสำคัญมีแหล่งต้นทางและวันที่เข้าถึง
- แยกข้อเท็จจริงออกจากการวิเคราะห์หรือข้อเสนอแนะ
- มี Original Value ที่มากกว่าการสรุปแหล่งอื่น
- ตรวจตัวเลข ชื่อ วันที่ และลิงก์ครบถ้วน
- ผู้เชี่ยวชาญมีอำนาจแก้หรือปฏิเสธบทความ
- ตรวจสิทธิ์ข้อมูล ภาพ และข้อมูลส่วนบุคคล
- ตรวจ Title และ Meta Description ไม่ให้กล่าวอ้างเกินจริง
- ตรวจ Structured Data และ Alt Text ให้ตรงกับเนื้อหา
- ระบุการใช้ Automation เมื่อเหมาะสมต่อบริบทและความคาดหวังของผู้อ่าน
- ทดสอบ Internal Link, Canonical, Mobile และ Accessibility
- มี KPI ด้านคุณค่าและคุณภาพ ไม่ใช่ Volume อย่างเดียว
- มี Correction Channel และ Correction Log
- กำหนด Review Date, Trigger และเกณฑ์ Retire
บทสรุป
Generative AI ทำให้ต้นทุนการร่างลดลง แต่ไม่ได้ลดความรับผิดชอบของผู้เผยแพร่ Google ไม่ได้วัดคุณภาพจากคำว่า “เขียนโดย AI” เพียงตัวแปรเดียว และนโยบาย Scaled Content Abuse ก็พิจารณาความมุ่งหมาย ความเป็นต้นฉบับ และคุณค่าต่อผู้ใช้ ไม่ว่าคอนเทนต์จะผลิตด้วยวิธีใด
ผู้บริหารจึงควรเปลี่ยนโจทย์จาก “ผลิตได้กี่ชิ้นต่อเดือน” เป็น “มีคอนเทนต์กี่ชิ้นที่ตรวจสอบได้ เพิ่มคุณค่าจริง และยังถูกต้องเมื่อเวลาผ่านไป” นี่คือจุดที่ Content Operations ต้องเชื่อม Data Governance, AI Governance, Editorial Governance และ Reputation Intelligence เข้าด้วยกัน
CTA: เปลี่ยน AI Content Pipeline ให้เป็น Intelligence ที่วัดและกำกับได้
IDA สามารถช่วยองค์กรออกแบบกระบวนการตั้งแต่ Data & Analytics สำหรับเชื่อมหลักฐานและวัดผล, AI Services สำหรับออกแบบ Workflow และ Human Review, Digital Intelligence & Reputation และ Blue Eye Social Listening สำหรับติดตามสัญญาณการรับรู้และความเสี่ยง ตลอดจน Graphic & Multimedia เพื่อสื่อสารข้อมูลที่ซับซ้อนอย่างเหมาะสมกับผู้ชม ทั้งหมดสอดคล้องกับแนวทาง Transform Data into Intelligence, Insights & Impact (IDA, บริการของ IDA, Technology)
จุดเริ่มต้นที่เหมาะสมคือเลือก Content Workflow ความเสี่ยงปานกลางหนึ่งชุด สร้าง Claim–Source Map และ Approval Gate ทดลองวัด Correction Rate กับ Verified Value ก่อนขยาย Automation ไปทั้งองค์กร
แหล่งอ้างอิง
วันที่เข้าถึงทุกแหล่ง: 9 ตุลาคม 2569
- Google Search Central. “Latest documentation updates.” รายการปรับปรุงคำแนะนำ Generative AI Content เผยแพร่ 1 ตุลาคม 2569.
- Google Search Central. “Google Search’s guidance on using generative AI content on your website.” เอกสารปรับปรุงต่อเนื่อง; อ้างอิงการปรับปรุงวันที่ 1 ตุลาคม 2569 จาก Change Log.
- Google Search Central. “Spam policies for Google web search.” เอกสารปรับปรุงต่อเนื่อง; ไม่ระบุวันเผยแพร่บนหน้า.
- Google Search Central. “Creating helpful, reliable, people-first content.” เอกสารปรับปรุงต่อเนื่อง; ไม่ระบุวันเผยแพร่บนหน้า.
- Google Search Central. “Optimizing your website for generative AI features on Google Search.” เผยแพร่ 15 พฤษภาคม 2569 ตาม Change Log ของ Google Search Central.
- Intelligent Data Analytic. “หน้าแรก.” เข้าถึง 9 ตุลาคม 2569.
- Intelligent Data Analytic. “เกี่ยวกับเรา.” เข้าถึง 9 ตุลาคม 2569.
- Intelligent Data Analytic. “บริการของเรา.” เข้าถึง 9 ตุลาคม 2569.
- Intelligent Data Analytic. “เทคโนโลยี.” เข้าถึง 9 ตุลาคม 2569.
ข้อจำกัดของข้อมูล
- เอกสาร Google อธิบายนโยบายและแนวทาง ไม่เปิดเผยน้ำหนักของสัญญาณจัดอันดับ และไม่ได้รับประกันการ Crawl, Index, Ranking หรือการปรากฏใน AI Search
- Search Quality Raters Guidelines ใช้ประเมินคุณภาพผลลัพธ์ของระบบ คะแนน Rater ไม่เปลี่ยนอันดับหน้าเว็บโดยตรง
- PROOF-7, Verified Value per Published Asset และตัวอย่างหน่วยงานรัฐเป็นข้อเสนอ/สถานการณ์จำลองของบทความนี้ ไม่ใช่มาตรฐานของ Google และไม่ใช่ผลงานลูกค้าจริงของ IDA
- การประยุกต์ใช้จริงต้องพิจารณากฎหมาย สิทธิในเนื้อหา นโยบายองค์กร และระดับความเสี่ยงของแต่ละอุตสาหกรรมเพิ่มเติม
อาจารย์ ปรเมศร์ เพียรสกุล
ประธานเจ้าหน้าที่บริหาร (Chief Executive Officer)
บริษัท อินเทลลิเจนท์ ดาต้า อนาไลติกส์ จำกัด (IDA)
CEO | AI, Cybersecurity & Digital Risk Strategist
Digital Crisis & Reputation Management
Certified AI Governance Professional (AIGP) | Data Protection Officer (DPO)
เกี่ยวกับผู้เขียน
Poramate Piansakul
Professional Certifications
Transforming Data into Trusted Intelligence for Executive Decision-Making
Intelligent Data Analytic (IDA)
Transform Data into Intelligence, Insights & Impact.
เปลี่ยนข้อมูลมหาศาลให้เป็น Intelligence ที่ผู้บริหารใช้ตัดสินใจได้ ตั้งแต่การเข้าใจสถานการณ์ ตรวจจับความเสี่ยง คาดการณ์แนวโน้ม ไปจนถึงสนับสนุนการตัดสินใจและการบริหารวิกฤต
#AIContentGovernance #GenerativeAI #AISEO #ContentGovernance #DigitalIntelligence




