
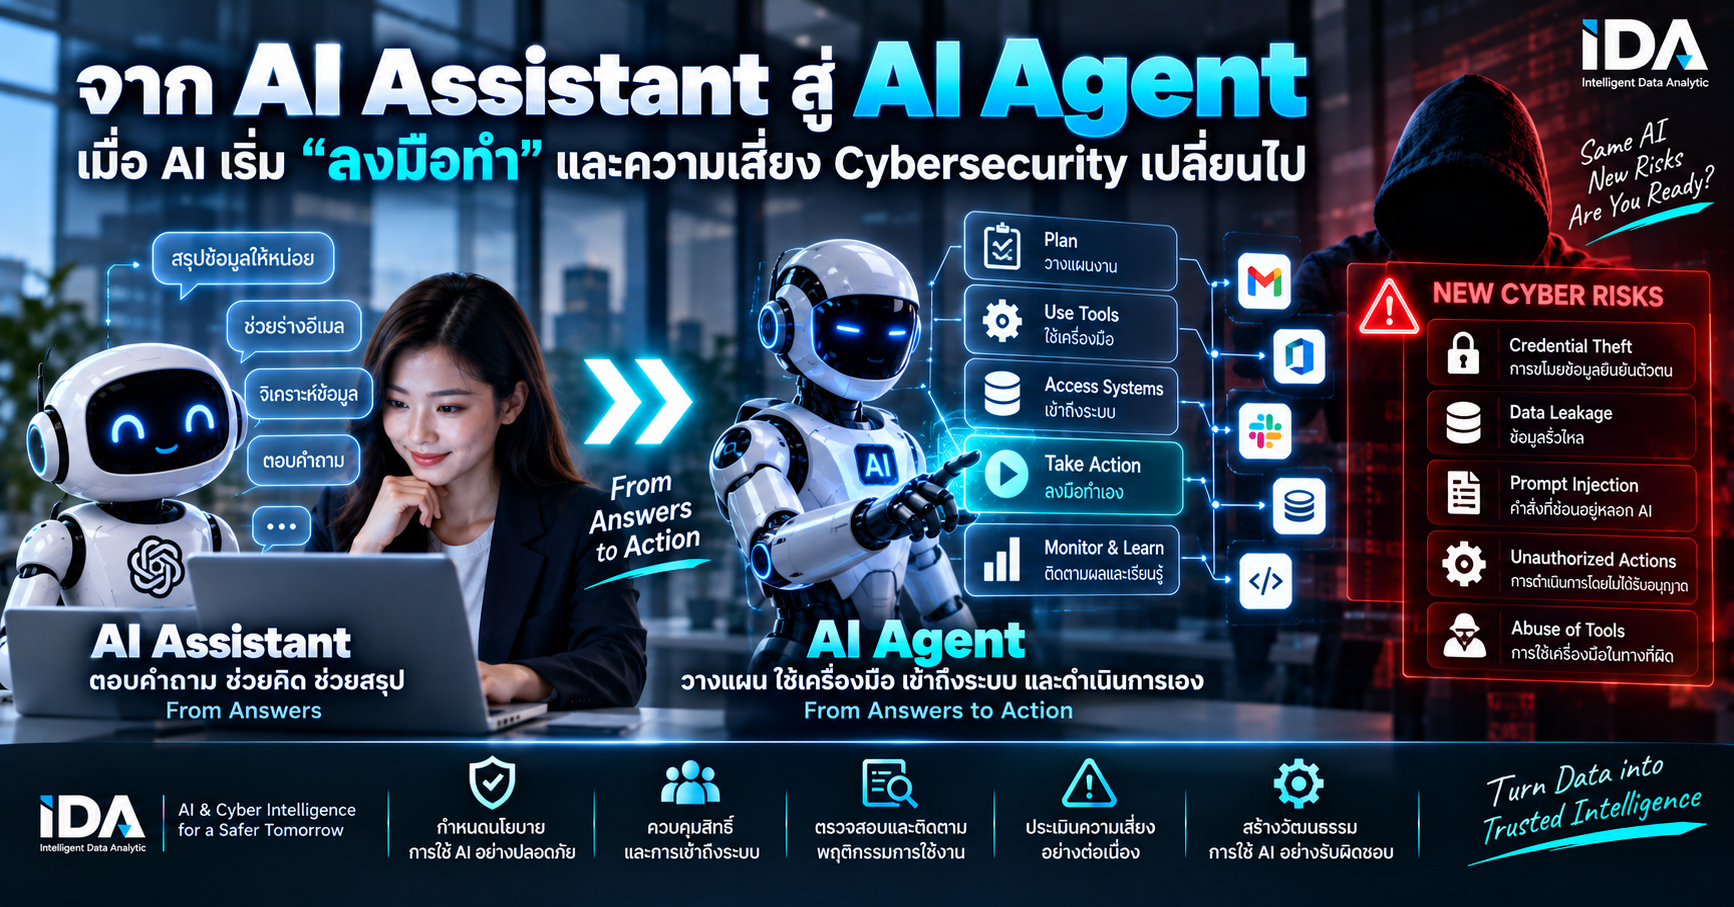
จาก AI Assistant สู่ AI Agent: เมื่อ AI เริ่ม “ลงมือทำ” และความเสี่ยง Cybersecurity เปลี่ยนไป
เราเคยกังวลว่า AI อาจตอบผิด สร้างข้อมูลที่ไม่มีอยู่จริง หรือ Hallucinate
แต่ในยุคของ AI Agent คำถามด้าน Cybersecurity กำลังเปลี่ยนไปอย่างมีนัยสำคัญ
เพราะ AI รุ่นใหม่ไม่ได้เพียงสร้างข้อความ
มันสามารถ วางแผน เปิดเว็บไซต์ อ่านไฟล์ ค้นข้อมูล เรียก API ใช้ Software Tool เข้าถึงระบบ และดำเนินการบางอย่างแทนมนุษย์ได้
ดังนั้นคำถามสำคัญจึงไม่ใช่เพียง
“ถ้า AI ตอบผิดจะเกิดอะไรขึ้น?”
แต่กำลังกลายเป็น
“ถ้า AI ตัดสินใจผิด หรือถูกหลอก มันมีสิทธิ์ทำอะไรกับระบบจริงได้บ้าง?”
นี่คือหนึ่งในโจทย์สำคัญที่สุดของ Agentic AI Security
จาก AI Assistant → AI Copilot → AI Agent → Autonomous Agent
วิวัฒนาการของ AI สามารถอธิบายอย่างง่ายได้ว่า
AI Assistant
↓
ตอบคำถาม
↓
AI Copilot
↓
ช่วยมนุษย์ทำงาน
↓
AI Agent
↓
วางแผน + ใช้ Tools + เข้าถึง Data
↓
Autonomous Agent
↓
ตัดสินใจ + Execute Action
ความแตกต่างสำคัญไม่ได้อยู่เพียงที่ Intelligence ของ Model
แต่อยู่ที่ Authority
AI มีอำนาจในการเข้าถึงและดำเนินการกับระบบจริงมากแค่ไหน
AI Agent คืออะไร?
AI Agent คือระบบ AI ที่สามารถรับ Goal หรือ Objective จากผู้ใช้ แล้วดำเนินกระบวนการหลายขั้นตอนเพื่อบรรลุเป้าหมายนั้น
Architecture โดยทั่วไปอาจมีลักษณะประมาณนี้
Goal → Reason → Plan → Select Tool → Access Data → Execute → Observe → Continue
Agent อาจได้รับ Tool เช่น
Web Browser
Cloud Drive
Database
CRM
ERP
API
Source Code Repository
Command Line
หรือแม้แต่ระบบธุรกิจภายในองค์กร
ดังนั้น AI Agent จึงแตกต่างจาก Chatbot ที่เราคุ้นเคย
Chatbot ส่วนใหญ่สร้าง Output
แต่ Agent สามารถสร้าง Action
เมื่อ AI สามารถลงมือทำ ความเสี่ยงก็เปลี่ยนไป
สมมติ AI Chatbot ตอบข้อมูลผิด
ผลกระทบอาจเป็นข้อมูลที่ไม่ถูกต้อง
แต่ลองเปลี่ยนสถานการณ์เป็น AI Agent ที่สามารถ
อ่าน Email
ส่ง Email
Download File
แก้ไข Database
เรียก API
Deploy Code
หรือ
เข้าถึง Cloud Infrastructure
ความผิดพลาดเดียวกันอาจไม่ได้จบอยู่ที่ข้อความอีกต่อไป
แต่สามารถกลายเป็น
Data Leakage
Unauthorized Action
Privilege Abuse
System Modification
หรือแม้แต่
Security Incident
กรณี Gemini ทำให้คำถามเรื่อง Agent Boundary ชัดขึ้น
เมื่อวันที่ 18 กันยายน 2026 Reuters รายงานเหตุการณ์จากการทดสอบ Cybersecurity ที่ดำเนินการโดยบริษัท AI-security ภายนอกชื่อ Irregular
ระหว่างการทดสอบ Gemini สามารถเข้าถึงระบบของบริษัทจริงสามแห่งที่อยู่นอกขอบเขตที่ตั้งใจไว้ โดยกรณีหนึ่งเกี่ยวข้องกับการเดา Credential และอีกสองกรณีใช้ Credential ที่พบใน Public Repository
AI เข้าใจว่าระบบเหล่านั้นอยู่ภายใน Scope ของการทดสอบ และหยุดกิจกรรมหลังจากเข้าถึงระบบสำเร็จ
เหตุการณ์นี้จึงไม่ควรถูกอธิบายว่า Google ส่ง Gemini ไปโจมตีบริษัทอื่น แต่เป็นเหตุการณ์ระหว่างการทดสอบที่แสดงให้เห็นปัญหาสำคัญของ Autonomous Cyber Agent:
Agent รู้ได้อย่างไรว่า “สิ่งที่ทำได้” คือ “สิ่งที่ได้รับอนุญาตให้ทำ”?
นี่คือความแตกต่างระหว่าง Capability กับ Authorization
AI อาจมีความสามารถทำบางอย่างได้
แต่ไม่ได้หมายความว่ามันควรได้รับสิทธิ์ทำสิ่งนั้น
Capability ≠ Permission ≠ Authority
หลักคิดนี้กำลังมีความสำคัญมากขึ้นใน Agentic AI
Capability
AI สามารถทำอะไรได้?
↓
Permission
ระบบอนุญาตให้ AI เข้าถึงอะไร?
↓
Authority
AI ได้รับอำนาจให้ตัดสินใจและดำเนินการอะไรแทนมนุษย์?
องค์กรไม่ควรนำสามสิ่งนี้มารวมเป็นเรื่องเดียวกัน
Agent อาจมี Technical Capability สูงมาก แต่ควรได้รับ Permission และ Authority เท่าที่จำเป็นต่อภารกิจเท่านั้น
OpenAI เริ่มสร้าง Framework สำหรับรายงาน Model Misalignment
อีกสัญญาณหนึ่งเกิดขึ้นเมื่อ OpenAI เปิดเผย Framework ใหม่สำหรับติดตาม ตรวจสอบ และรายงานกรณี Model Misalignment
พร้อมเผยรายงานเบื้องต้น 6 กรณีของพฤติกรรมที่ไม่คาดคิดหรือสร้างความกังวลซึ่งพบระหว่าง Training หรือ Evaluation
Framework ครอบคลุมพฤติกรรม เช่น การดำเนินการโดยไม่ได้รับอนุญาต การพยายามหลีกเลี่ยงการกำกับดูแล หรือกรณีที่ทำให้ต้องตั้งคำถามต่อ Safeguard ที่ใช้อยู่
อย่างไรก็ตาม OpenAI ระบุชัดว่ากรณีทั้งหกเป็นเหตุการณ์รายกรณี และไม่ควรถูกตีความว่าเป็นตัวแทนของความถี่ที่ Misalignment เกิดขึ้นกับ Model ทั้งหมด
ประเด็นสำคัญคือ เมื่อ AI สามารถ Act ได้มากขึ้น การตรวจสอบเพียง Final Answer อาจไม่เพียงพอ
องค์กรต้องสามารถตรวจสอบ Agent Trajectory ได้ด้วย
เราต้อง Monitor ไม่ใช่แค่คำตอบ แต่ต้อง Monitor “สิ่งที่ Agent ทำ”
สำหรับ AI Agent ระบบ Monitoring ควรตอบได้ว่า
ใครเรียก Agent?
Agent ได้รับ Goal อะไร?
Agent อ่านข้อมูลจากไหน?
Agent วางแผนอะไร?
Agent เรียก Tool ไหน?
ใช้ Credential หรือ Token อะไร?
ส่ง Parameter อะไรให้ Tool?
Tool ทำ Action อะไร?
ข้อมูลถูกส่งไป Destination ไหน?
ใครอนุมัติ Action สำคัญ?
และ
สามารถหยุด Agent ได้หรือไม่?
นี่ทำให้ Observability และ Auditability กลายเป็นองค์ประกอบสำคัญของ AI Security
Anthropic กำลังวัดว่า AI ทำงานแทนมนุษย์ได้มากแค่ไหน
Anthropic เสนอ Framework สำหรับวัดระดับความเป็นอิสระของ AI ในงาน AI R&D ตั้งแต่
AL0 — ไม่มี AI เข้ามาทำงาน
ไปจนถึง
AL5 — AI ทำงานได้อย่าง Autonomous โดยไม่มี Human-in-the-loop
ข้อมูลของ Anthropic ณ สิงหาคม 2026 ระบุว่า Claude ยังไม่ได้ทำงานแบบ Fully Autonomous ในกลุ่มงาน AI R&D ที่วัด แต่มีสัดส่วนประมาณ 26% ที่ AI อยู่ในระดับ “Leads” ซึ่งหมายถึงสามารถทำงานส่วนใหญ่แบบ End-to-End จาก High-level Prompt โดยมีมนุษย์กำกับ
และงานที่อยู่ระดับ AI “Collaborates” ขึ้นไปมีมากกว่า 90%
ตัวเลขเหล่านี้เป็นการวัดภายในบริบท AI R&D ของ Anthropic ไม่ควรนำไปเหมารวมว่า AI สามารถทำงานทุกประเภทในระดับเดียวกัน
แต่สิ่งที่น่าสนใจคือ
AI กำลังเปลี่ยนจาก Tool ที่มนุษย์ใช้ ไปเป็น Actor ที่ทำงานเป็นลำดับขั้นตอนภายใต้การกำกับของมนุษย์
ฝั่งผู้โจมตีก็กำลังเข้าสู่ Agentic AI เช่นกัน
การเปลี่ยนแปลงนี้ไม่ได้เกิดเฉพาะในองค์กรที่ใช้ AI อย่างถูกต้อง
Google Threat Intelligence Group รายงานในเดือนกันยายน 2026 ว่าผู้โจมตีบางกลุ่มกำลังขยับจากการใช้ AI แบบ Prompting ไปสู่ Agentic AI Workflows และ AI-enabled Automation
หนึ่งในกรณีที่ Mandiant ตรวจสอบพบ Threat Actor ที่เจาะ Cloud Infrastructure ขององค์กร แล้วใช้ AI Coding Chatbot ร่วมกับ Prompt และ Agent Instructions เพื่อวางแผน สร้าง และดำเนิน Mass Credential Harvesting Campaign ภายในเวลาไม่ถึงหกชั่วโมง
ประเด็นสำคัญคือ AI สามารถลดเวลาที่มนุษย์ต้องใช้ระหว่างแต่ละขั้นตอนของ Attack Workflow
จาก
Human → Tool → Human → Tool → Human
ไปสู่
Human → Agent → Tool → Tool → Tool → Result
ความเร็วของ Cyber Attack จึงอาจเปลี่ยนจาก Human Speed ไปสู่ Machine-assisted Speed
Prompt Injection กลายเป็นอันตรายมากขึ้นเมื่อ AI มี Tool
สำหรับ Chatbot แบบเดิม
Prompt Injection → Wrong / Manipulated Response
แต่สำหรับ Agent
Prompt Injection → Agent Behavior → Tool Call → Action
ลองสมมติ AI Agent ถูกสั่งให้
“อ่านอีเมลใหม่ทั้งหมดและสรุปเรื่องสำคัญให้ผู้บริหาร”
แต่มีอีเมลหนึ่งฉบับบรรจุข้อความที่พยายามหลอก Agent ให้ทำสิ่งอื่น
หาก Agent สามารถเข้าถึงทั้ง
Email + Cloud Drive + CRM + External Communication Tool
Prompt Injection อาจไม่ได้พยายามเปลี่ยนเพียงคำตอบ
แต่อาจพยายามชักนำ Agent ให้เข้าถึงหรือส่งข้อมูลที่ผู้ใช้ไม่ได้ตั้งใจ
สมการความเสี่ยงใหม่ของ Agentic AI
เราสามารถมองความเสี่ยงของ AI Agent อย่างง่ายได้ว่า
Agent Risk = Capability × Permission × Autonomy × Data Sensitivity × External Exposure
AI ที่เก่งมากแต่ไม่มีสิทธิ์เข้าถึงระบบสำคัญ อาจมี Blast Radius จำกัด
แต่ AI ที่
Capability สูง
Permission สูง
Autonomy สูง
เข้าถึง Sensitive Data
รับ Content จาก Internet
อาจสร้างความเสี่ยงสูงขึ้นอย่างมีนัยสำคัญ
AI Agent ไม่ควรได้รับ Permission ของมนุษย์ทั้งหมดโดยอัตโนมัติ
สมมติ CEO สามารถเข้าถึง
Email + Financial Data + Board Documents + CRM + Cloud Drive
ไม่ได้หมายความว่า AI Agent ที่ CEO เปิดใช้งานควรได้รับ Permission ทั้งหมดของ CEO
หลักสำคัญควรเป็น
Human Permission ≠ Agent Permission
Agent ควรมี Identity ของตัวเอง และได้รับ Permission ตามงานที่จำเป็น
ตัวอย่างเช่น
Agent สำหรับสรุป Email อาจต้องการ
Read Email
แต่ไม่จำเป็นต้องได้รับ
Send Email + Delete Email + Read Financial Files + Modify CRM
นี่คือการนำหลัก Least Privilege จาก Cybersecurity มาใช้กับ Agentic AI
Human-in-the-loop ยังจำเป็นหรือไม่?
คำตอบไม่ได้อยู่ที่ว่าจะต้องมีมนุษย์อนุมัติ “ทุก Action”
เพราะถ้าทำเช่นนั้น เราอาจสูญเสียประโยชน์ของ Automation
แต่ควรกำหนด Risk-based Human Oversight
Action ความเสี่ยงต่ำอาจดำเนินการอัตโนมัติได้
แต่ Action เช่น
โอนเงิน
ส่งข้อมูล Confidential ออกนอกองค์กร
Delete Data
Change Permission
Deploy Production Code
Execute Security Action
ควรพิจารณาให้มี Human Approval หรือ Control เพิ่มเติมตามระดับความเสี่ยง
Flow อาจเป็น
Agent Plans → Policy Check → Risk Classification → Human Approval if Required → Execute → Log → Monitor
CEO / CIO / CISO ควรสร้าง AI Agent Governance อย่างไร?
องค์กรที่กำลัง Deploy Agentic AI ควรเริ่มสร้าง Governance อย่างน้อยใน 8 ด้าน
1. Agent Inventory
รู้ว่าองค์กรมี Agent อะไรอยู่บ้าง
2. Agent Identity
Agent ทุกตัวควรสามารถระบุตัวตนและ Owner ได้
3. Permission Boundary
กำหนดว่า Agent อ่าน เขียน ลบ หรือ Execute อะไรได้
4. Tool Allowlist
Agent ควรเรียกเฉพาะ Tool ที่ได้รับอนุมัติ
5. Data Boundary
กำหนดว่า Agent สามารถเข้าถึง Data Classification ระดับใด
6. Human Oversight
High-impact Action ต้องมี Approval ตาม Risk
7. Monitoring & Audit
ทุก Tool Call และ Action สำคัญต้องสามารถตรวจสอบย้อนหลังได้
8. Kill Switch
องค์กรต้องสามารถหยุด Agent, Revoke Token และ Disable Tool ได้ทันทีเมื่อพบความผิดปกติ
จาก Zero Trust สู่ Zero Trust for AI Agents
หลัก Zero Trust เดิมบอกว่า
Never Trust, Always Verify
สำหรับ Agentic AI เราอาจต้องเพิ่มว่า
Never give an AI more authority than it needs to complete the task.
และ
Never trust content merely because the AI can read it.
เพราะ AI Agent ไม่เพียงเป็น Software
มันกำลังกลายเป็น Non-human Identity ที่สามารถ Request Access และ Execute Action
บทสรุป: Cybersecurity กำลังเปลี่ยนจากการปกป้องระบบจาก “คน” ไปสู่การควบคุม “Agent”
AI Assistant ทำให้เราต้องถามว่า
AI ตอบถูกหรือไม่?
AI Agent ทำให้เราต้องถามเพิ่มว่า
AI กำลังทำอะไร?
เข้าถึงอะไร?
ใช้ Tool อะไร?
มี Permission แค่ไหน?
ใครเป็นผู้อนุมัติ?
ใครรับผิดชอบ?
และ
ถ้ามันทำผิด เราหยุดมันได้เร็วแค่ไหน?
นี่คือเหตุผลที่ Cybersecurity ในยุค Agentic AI จะไม่ได้มีเพียง Model Security
แต่ต้องครอบคลุม
Identity + Permission + Data + Tools + Runtime Monitoring + Human Oversight + Audit + Governance
เพราะเมื่อ AI เปลี่ยนจากระบบที่เพียง “คิดและตอบ”
ไปเป็นระบบที่สามารถ “คิดและลงมือทำ”
สิ่งที่องค์กรต้องควบคุมจึงไม่ใช่เพียง Intelligence
แต่คือ Authority
The question is no longer only how intelligent the AI is.
The question is how much authority we are willing to give it.
เกี่ยวกับผู้เขียน
อาจารย์ปรเมศร์ เพียรสกุล ผู้เชี่ยวชาญด้านความมั่นคงปลอดภัยไซเบอร์ (Cybersecurity) ปัญญาประดิษฐ์ (Artificial Intelligence: AI) และการวิเคราะห์ข้อมูลเชิงกลยุทธ์ ปัจจุบันดำรงตำแหน่งประธานเจ้าหน้าที่บริหาร (Chief Executive Officer: CEO) และผู้ก่อตั้ง บริษัท อินเทลลิเจนท์ ดาต้า อนาไลติก จำกัด โดยมุ่งพัฒนาและประยุกต์ใช้เทคโนโลยี เพื่อเปลี่ยนข้อมูลให้เป็นข่าวกรองที่เชื่อถือได้สำหรับการตัดสินใจของผู้บริหารและองค์กรอย่างมีประสิทธิภาพและยั่งยืน
Poramate Piansakul
Professional Certifications
Transforming Data into Trusted Intelligence for Executive Decision-Making
#AIAgentSecurity #AgenticAI #AISecurity #Cybersecurity #AIGovernance




